'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
训练
指定预处理后的数据集、基础模型和训练方法(STAGE),然后执行微调。
1. 选择训练数据集
这里选择的不是原始源文件夹,而是已经整理为训练用的数据集文件夹。可以从 团队 AppData 训练集、个人 AppData 训练集 中选择,或者通过 自定义... 直接输入路径。选择文件夹后会立即在下方进行验证,并显示可用于训练的文件数量。
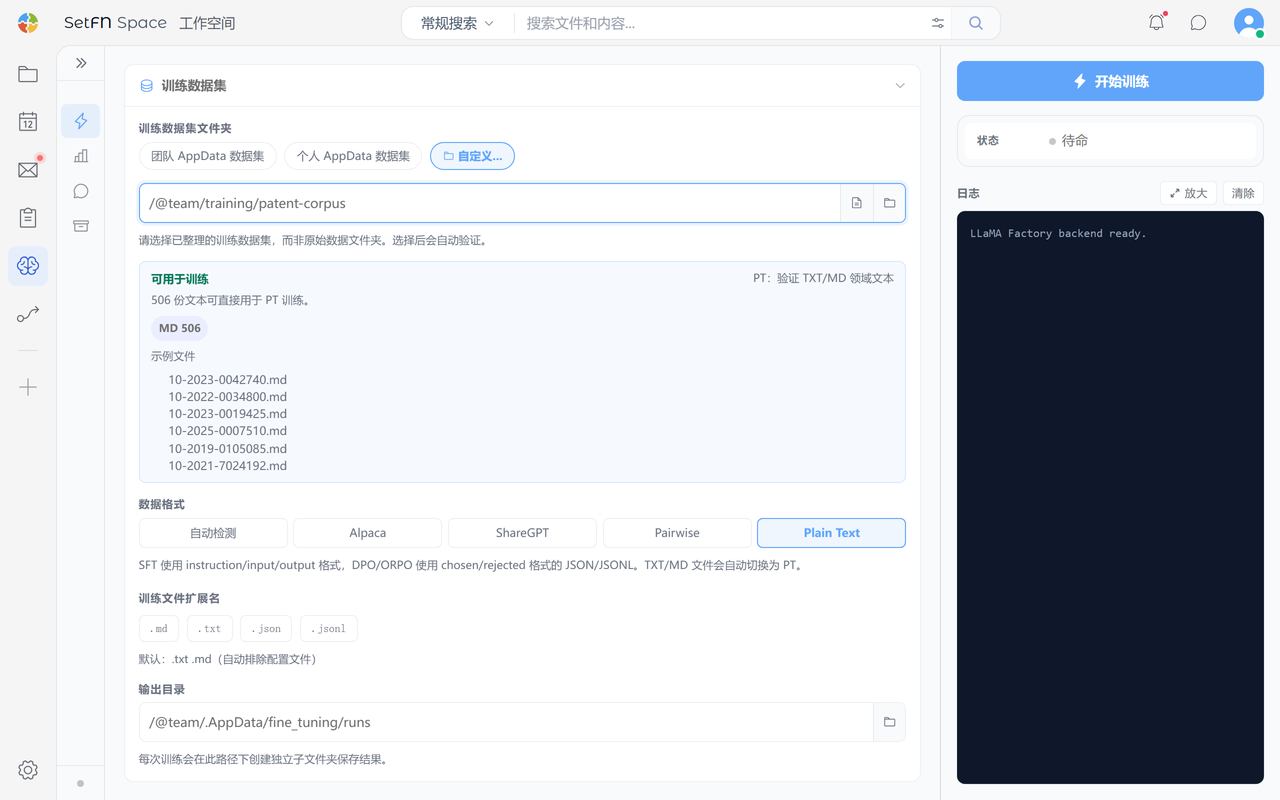
数据格式
从自动检测、Alpaca、ShareGPT、Pairwise、Plain Text 中选择。
- SFT 使用基于 instruction/input/output 的 JSON/JSONL。
- DPO/ORPO 使用基于 chosen/rejected 的 JSON/JSONL。
- .txt/.md 原文仅用于 Plain Text(PT 预训练),选择后阶段会自动切换为 PT。
训练文件扩展名与输出目录
选择要纳入训练的文件扩展名(.md、.txt、.json、.jsonl),并指定保存训练结果的输出目录。执行结果会按 Run 编号自动生成子文件夹,分别单独保存。
2. 选择模型
直接输入 HUGGINGFACE MODEL ID,或在搜索框中搜索模型。也可以从 Qwen2.5-7B-Instruct、Qwen2.5-14B-Instruct、Gemma-2-9B-It、Llama-3.1-8B-Instruct、DeepSeek-R1-14B、DeepSeek-R1-8B 中快速选择。
CHAT TEMPLATE 默认使用基于模型名称的自动检测(推荐)。只有在运行异常时才手动选择。
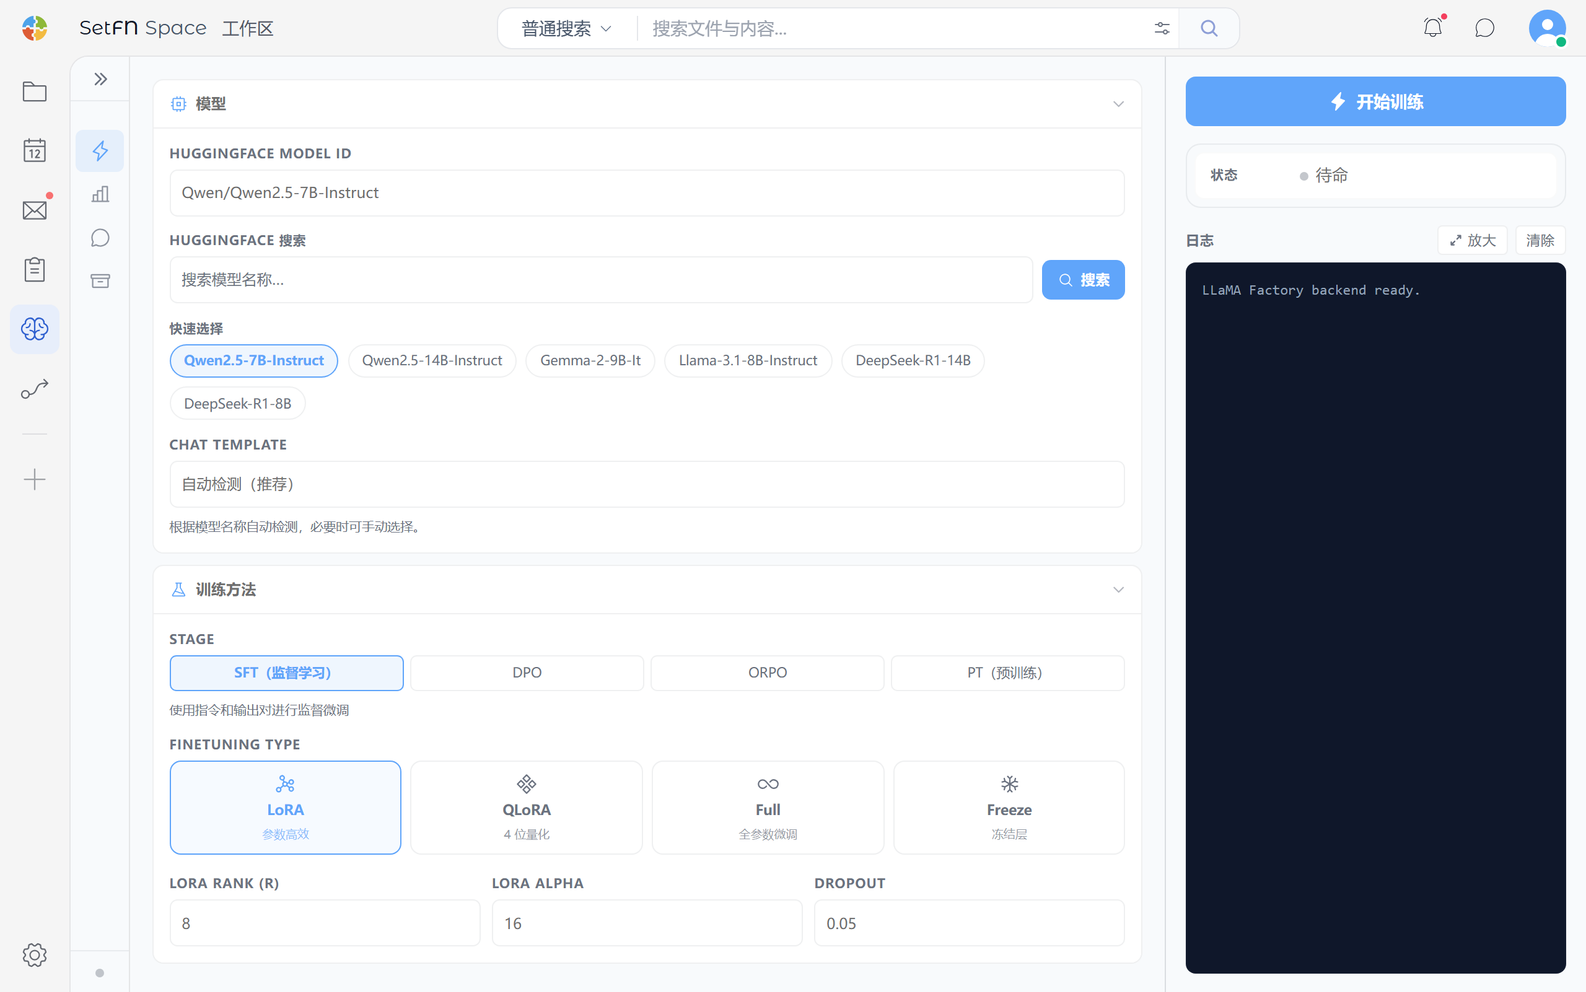
3. 选择训练方法(STAGE)与微调方式
| STAGE | 说明 |
|---|---|
| SFT(监督学习) | 使用 instruction/input/output 数据教模型完成特定任务 |
| DPO | 使用 chosen/rejected 数据训练偏好 |
| ORPO | 与 DPO 类似的基于偏好的对齐方式 |
| PT(预训练) | Continued Pre-Training。使用纯文本训练领域知识 |
FINETUNING TYPE 可从 LoRA、QLoRA(4-bit 量化)、Full(全量微调)、Freeze(冻结层)中选择。还可以调整 LoRA RANK、LORA ALPHA、DROPOUT 等详细超参数。
4. 开始训练
点击 开始训练 按钮即开始训练。在右侧面板中可以实时查看状态、模型、RUN ID、结果模型路径和进度,同时会输出日志。要停止训练,请点击 停止 按钮。
注意事项
- 如果数据格式与目标阶段不匹配,训练可能无法开始。
- 训练过程中无法更改同一 Run 的设置。