'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
训练数据预处理
将原始数据(XML、HTML、JSON、TXT)按训练目的(PT·SFT)进行转换和清洗,并直接衔接到训练标签页。
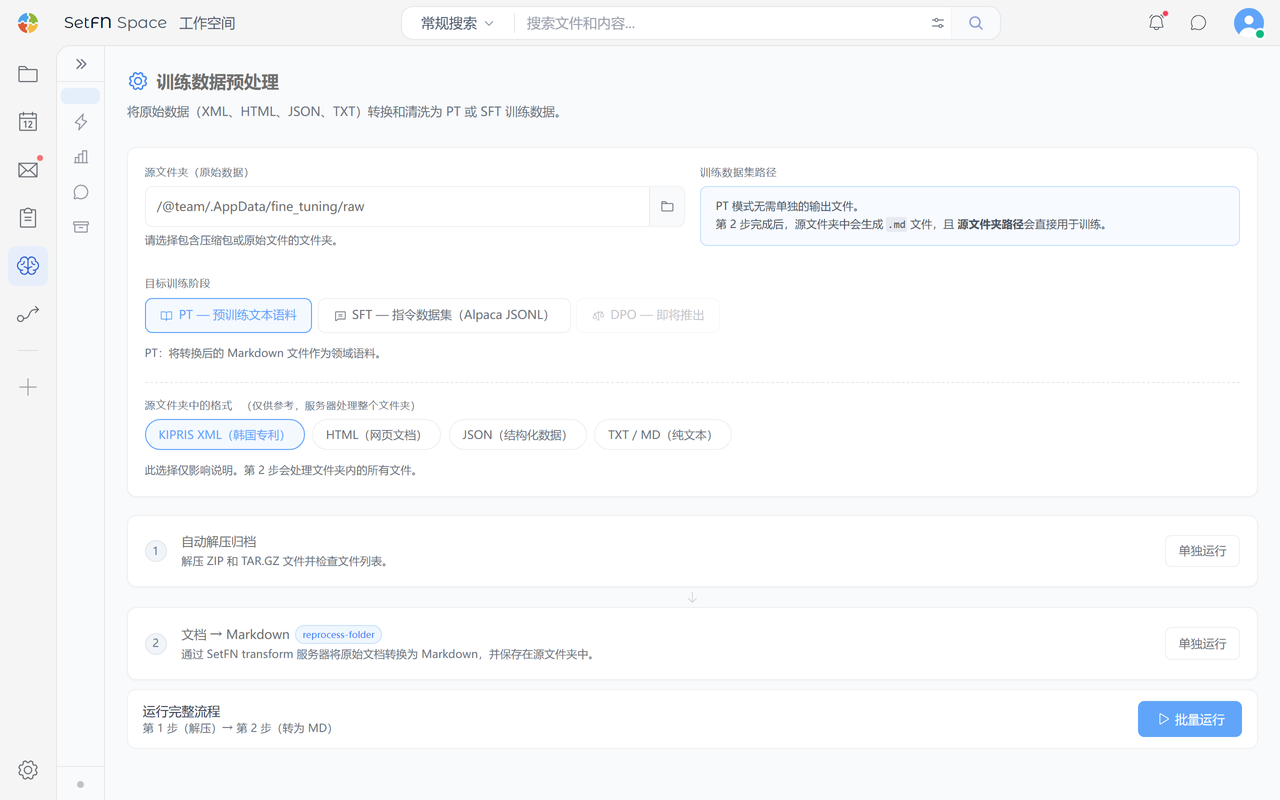
指定源文件夹
指定存放压缩文件(.zip/.tar.gz)或原始文件(XML、HTML、JSON、TXT 等)的源文件夹路径。默认路径为 /@team/.AppData/fine_tuning/raw。
选择目标训练阶段
选择要转换的数据的用途。
| 阶段 | 说明 |
|---|---|
| PT — 预训练原文语料 | 将转换后的全部 MD 文件作为领域语料用于预训练 |
| SFT — 指令数据集(Alpaca JSONL) | 转换为 instruction/input/output 格式的指令数据集 |
| DPO | 尚不支持 |
PT 模式不需要单独的输出文件。转换完成后会在源文件夹中生成 .md 文件,源文件夹路径会直接衔接到训练标签页。
选择 SFT 时会显示 最终输出文件路径(JSONL)。留空时会以 dataset.jsonl 保存在源文件夹中。
源文件夹中包含的原始格式
仅供参考,用于标明源文件夹中混有哪些格式的原始文件。可以从 KIPRIS XML(韩国专利)、HTML(网页文档)、JSON(结构化数据)、TXT/MD(普通文本)中选择,该选择只会反映在下方的流水线说明中。服务器实际处理时会批量转换文件夹内的所有文件。
执行流水线
PT 的流水线由两个步骤组成,SFT 由三个步骤组成。每个步骤可以单独执行,也可以一次性批量执行。
- 自动解压压缩包:自动解压源文件夹内的 .zip·.tar.gz 文件并确认文件列表。
- 文档 → Markdown 转换:将源文件夹内的文档文件(XML、HTML、JSON 等)批量转换为 Markdown。转换后的 .md 文件会生成在源文件夹中。
- 生成 Alpaca JSONL(SFT 用):仅在选择 SFT 时显示。将 .md·.txt 文件转换为 instruction/input/output 结构的 Alpaca JSONL。
在 一键执行整个流水线 中点击 批量执行 按钮,所有步骤会依次执行。完成后,选择 连接到训练(Train)标签页,将数据集传递到训练标签页。