'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
聊天测试
加载或连接训练完成的模型,通过直接对话确认微调结果。
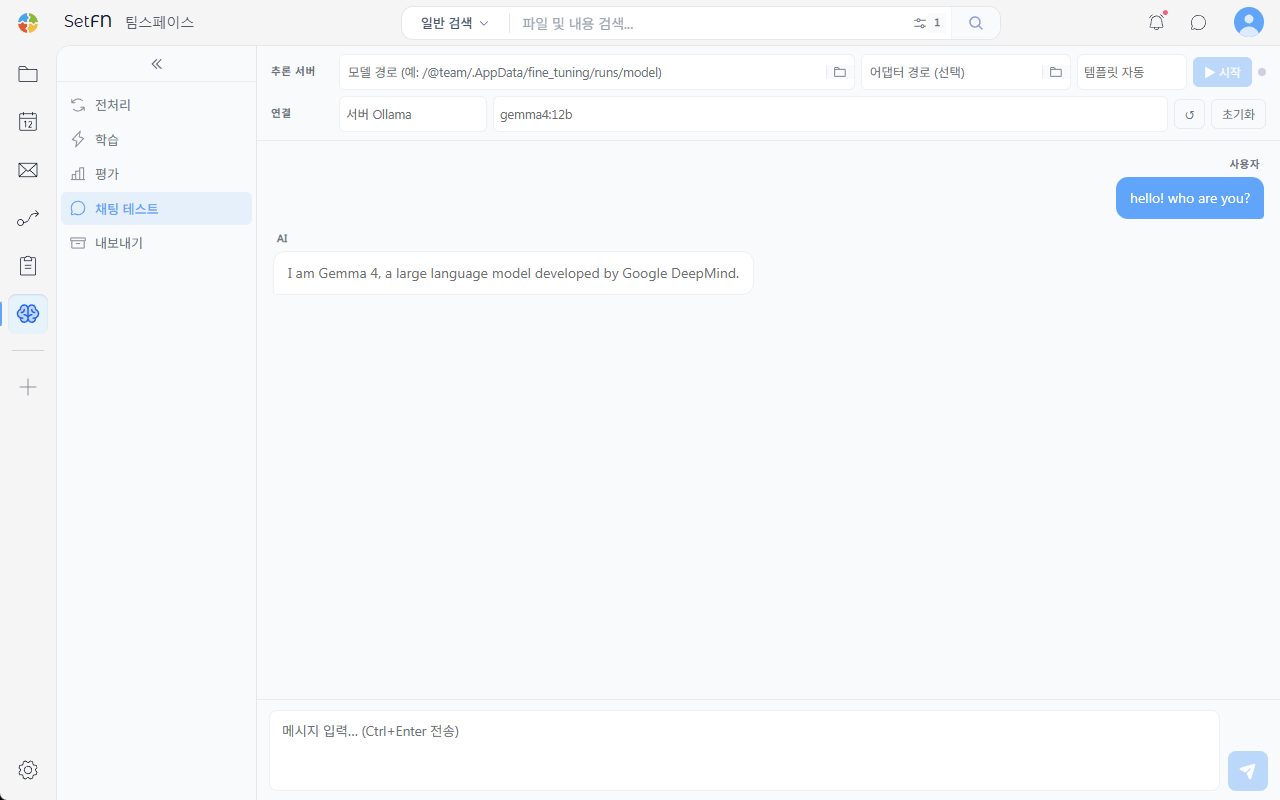
通过推理服务器加载模型
直接加载训练结果模型进行测试。
- 模型路径:输入要测试的模型路径(例如
/@team/.AppData/fine_tuning/runs/model) - 适配器路径(可选):如果只单独使用通过 LoRA 等方式训练的适配器权重,请指定其路径
- 模板:默认自动检测
输入路径后点击 开始 按钮,推理服务器即开始运行,连接 会切换为 推理服务器。
连接 Ollama 服务器
也可以直接使用已在 Ollama 中注册的模型进行测试。
- 在
连接中选择服务器 Ollama或本地 Ollama(我的电脑)。 - 点击刷新按钮(
↺)加载模型列表。 - 选择要测试的模型(例如
gemma4:12b)。
选择 自定义 API 时,需要直接输入 API 地址和模型名称。点击 重置 按钮会清空对话内容。
通过对话确认结果
在底部输入框中输入消息,按 Ctrl+Enter(或点击发送按钮)发送后,用户消息和 AI 回复会以聊天形式显示。提出符合训练意图的问题,确认回复的质量和格式。
注意事项
- 仅完成 PT(预训练)的模型可能不会进行遵循指令的对话,而是给出续写形式的回复。要查看遵循指令的对话质量,请使用完成 SFT 的模型进行测试。
- 模型路径为空时无法点击
开始。使用适配器时也需要同时指定模型路径。