'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
微调简介
微调插件基于 LLaMA Factory,可将本地 LLM(包括 sLLM 等小型语言模型)训练成适合目标领域的模型。从原始数据预处理到训练、评估、聊天测试,再到导出结果模型,全部流程都可以在同一个界面中完成。
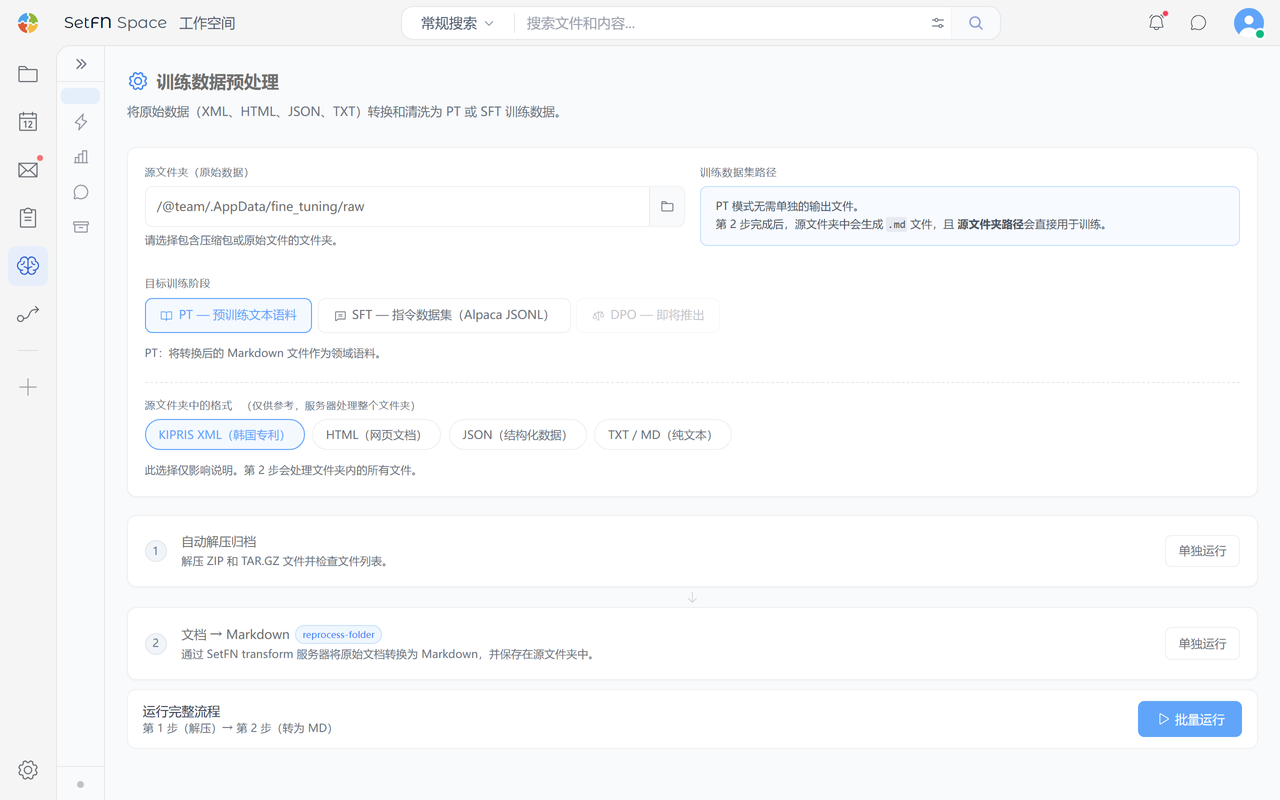
工作流程
微调按以下 5 个步骤进行。
| 步骤 | 说明 |
|---|---|
| 预处理 | 将原始数据(XML、MD、HTML、JSON、TXT)按训练目的(PT·SFT)进行转换和清洗 |
| 训练 | 指定数据集、模型和训练方法(STAGE)后执行微调 |
| 评估 | 检查已完成的训练 Run 结果,并重新检查数据集的有效性 |
| 聊天测试 | 与训练好的模型直接对话,确认结果 |
| 导出 | 管理训练 Run,并将结果权重衔接为下一次微调的 Base Model |
注意事项
- 训练需要 GPU 资源。请提前确认服务器规格。
- 训练过程中,在停止之前会一直在后台持续进行。