'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
搜索质量与语言
在一处集中管理提高普通搜索和 AI 搜索准确度的设置。可以设置形态分析、同义词词典和 AI 请求分类,还可以审核拼写错误候选词并将其登记到同义词词典中。
要使用 AI 请求分类,必须先在 AI 模型设置中配置 AI 运行时。
开始之前
- 所需权限:Workspace 管理员
- 形态分析设置和同义词更改会同时影响普通搜索和 AI 搜索。
打开搜索质量与语言
- 访问管理员页面。
- 在左侧菜单中选择
知识服务。 - 选择
搜索质量与语言。
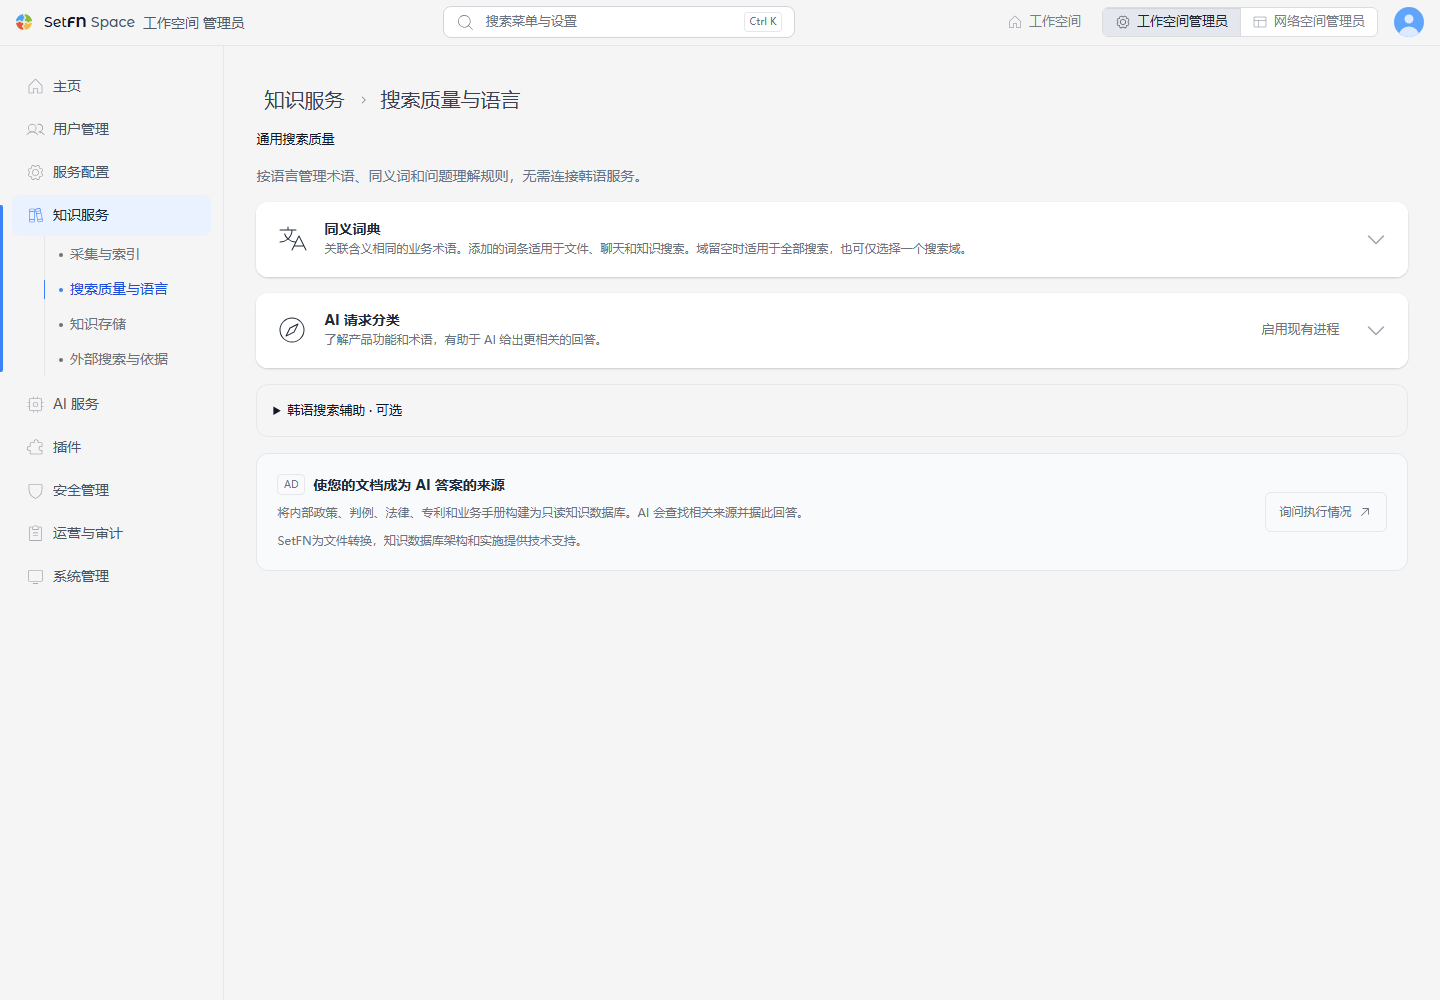
形态分析器
确认当前搜索方式和分析器信息后,选择搜索方式并保存。如果出现服务器重启提示,请安排操作时间后重启。保存的方式与当前应用的方式可能不同,因此重启后请确认当前搜索方式。
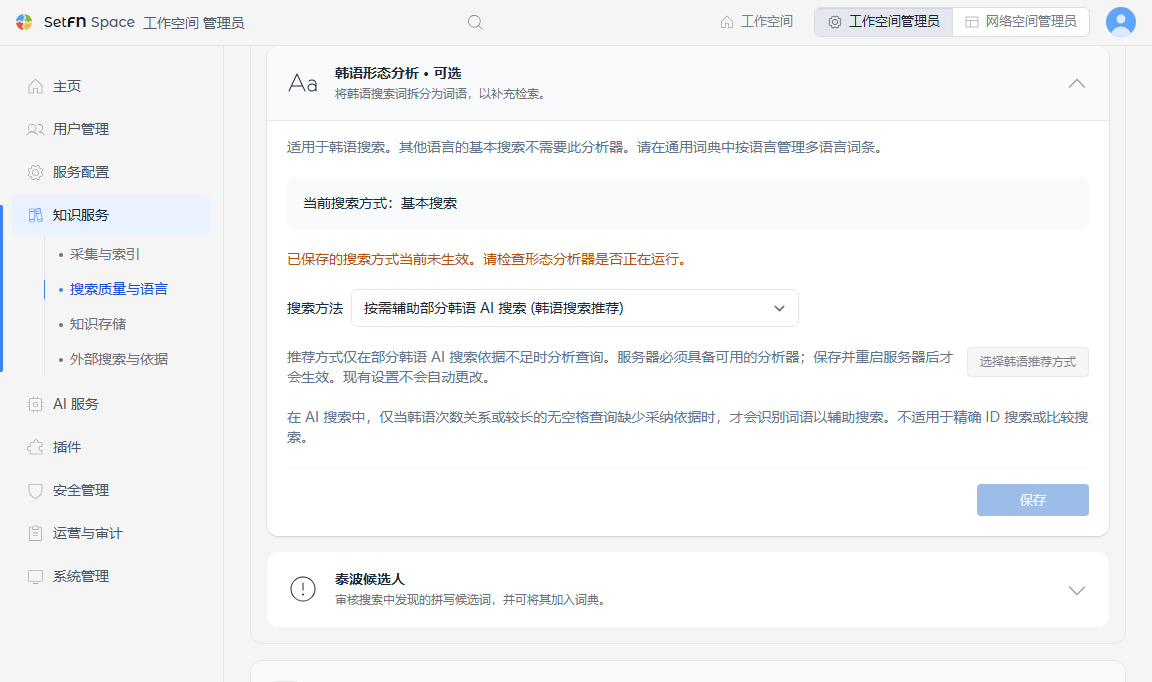
| 搜索方式 | 行为 |
|---|---|
基本搜索 | 按输入的搜索词查找的原有方式。 |
将搜索词拆分为词语搜索 | 将搜索词按词语拆分后查找。 |
依据不足时辅助搜索词 | 推荐方式。仅在 AI 搜索依据不足时,将搜索词拆分为词语重新查找。不用于 ID 搜索和比较搜索。 |
依据不足时同时使用文档索引辅助 | 准备文档的词语辅助索引,当已确认权限的原文回答依据不足时,使用搜索词和辅助索引重新查找。 |
将搜索词和文档拆分为词语搜索 | 将搜索词和文档内容都按词语整理。 |
使用推荐方式只更改选中的值。必须完成保存和服务器重启才会生效,现有设置不会自动更改。服务器上必须已准备好形态分析器。
如果更改为使用文档词语索引的方式,现有文档必须在采集与索引中重新处理。文档形态分析处理状态是服务器启动以来的任务累计,不是全部文档的完成率。
同义词词典
将写法不同但含义相同的业务术语关联起来。登记的同义词会同时应用于普通(文件)搜索、聊天搜索、评论搜索和知识库搜索。系统默认同义词不会显示在列表中。
示例
下面是将네이버(Naver)、인스타그램(Instagram)、카카오톡(KakaoTalk)登记为规范词的示例。
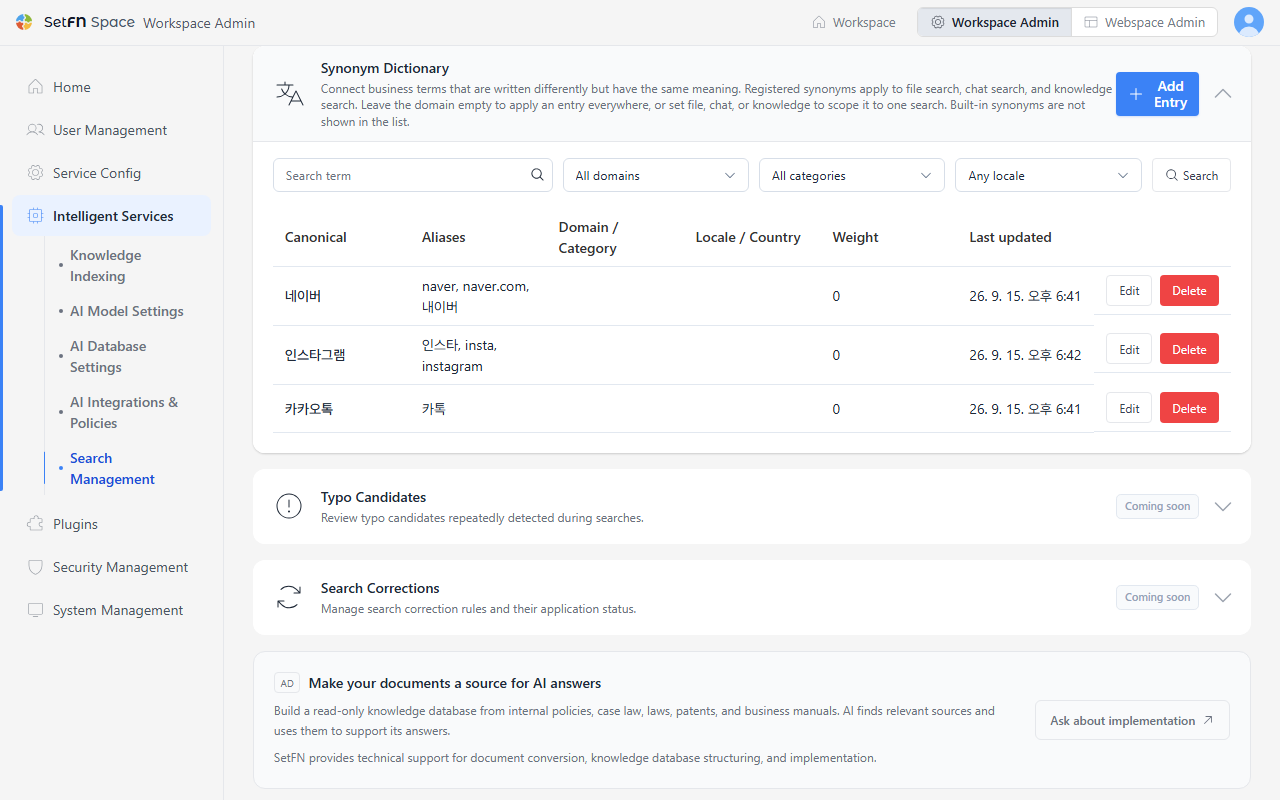
将네이버登记为规范词,并将naver、naver.com、내이버登记为别名后,即使用户搜索naver,也能同时找到包含네이버的文档和评论。同样,如果将카톡这类日常工作中常用的缩写登记为카카오톡的别名,即使写法不同也不会遗漏搜索结果。
可以通过搜索词、所有域、所有类别条件查找已登记的同义词。
添加同义词条目
- 选择
添加条目。 - 在
规范词中输入作为基准的术语。 - 在
别名中输入替换为规范词后含义不变的表达,以逗号分隔。 - 如有需要,输入
权重(0~1000,值越高在自动完成候选中越优先)、搜索域、类别、语言区域、国家、说明。 - 选择
保存。
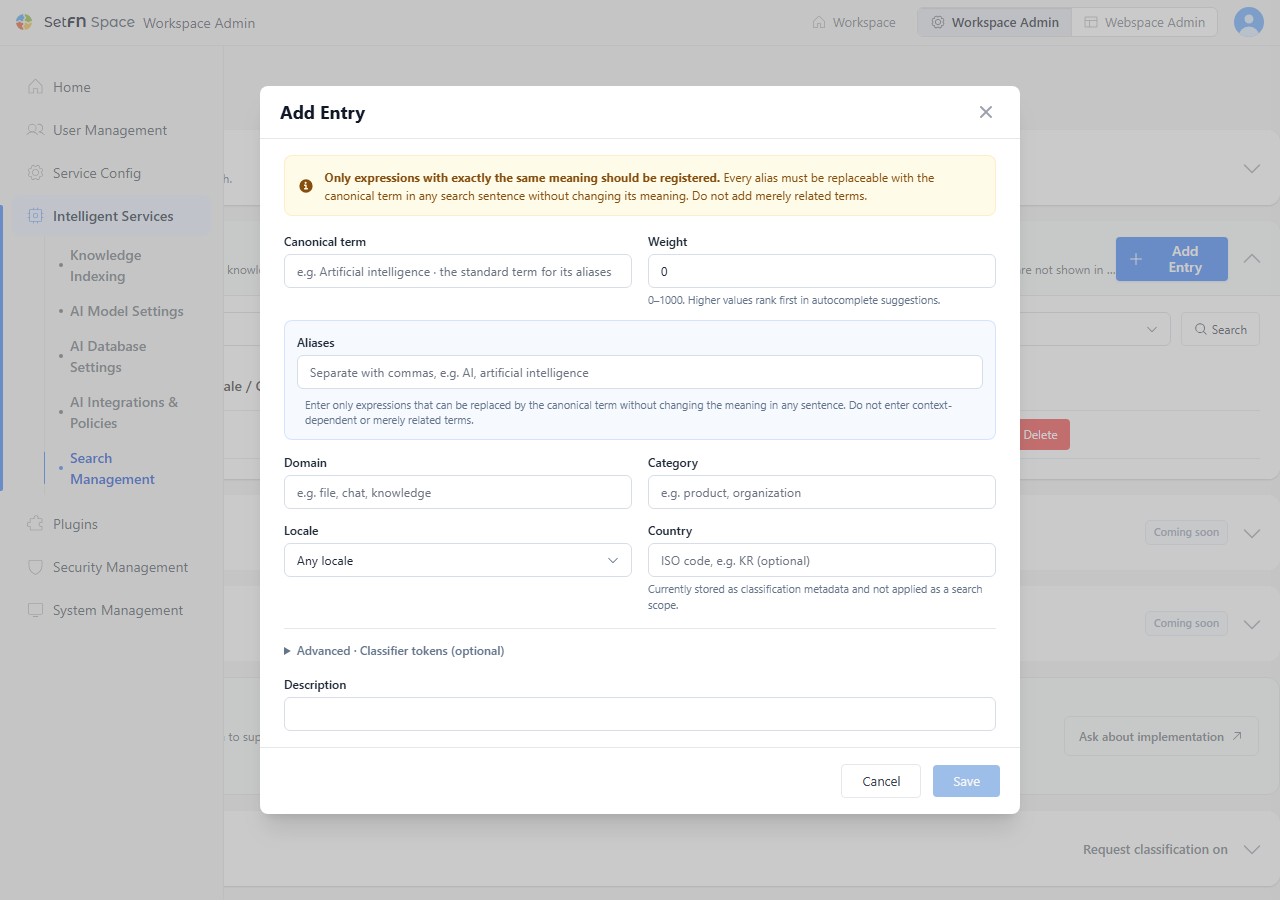
国家目前仅作为分类元数据保存,不应用于搜索范围。
可以使用所有语言区域筛选器缩小词典列表。高级输入中的标记仅用于自动完成和分类,不会扩展为搜索同义词。
AI 请求分类
AI 理解产品的功能和术语后,可以更贴切地回答问题。
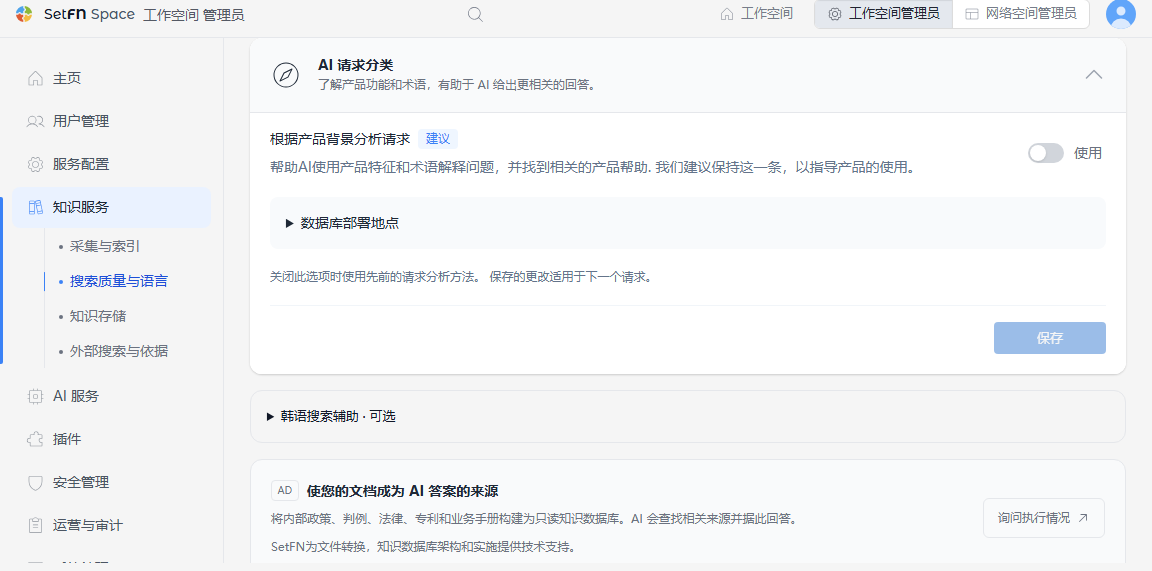
开启根据产品背景分析请求后,AI 会基于产品的功能和术语解释问题,并帮助查找所需的产品帮助。打开知识库部署位置可以查看所引用的数据库路径。
| DB | 路径 | 说明 |
|---|---|---|
| 产品帮助 DB | resources/product-help/product-help-<locale>.db | 包含产品使用方法和功能说明的按语言划分的数据库。 |
| 领域专家知识 DB(即将接入) | resources/knowledge/catalog.json、resources/knowledge/collections/<collection-id>-<locale>.db | AI 将法规、判例等经专家审核的资料作为回答依据来引用的只读数据库。AI 不会修改数据库原文。 |
完成设置后选择保存。
审核拼写错误候选词
- 展开
拼写错误候选卡片。 - 确认输入的词、建议的词、发现路径、应用范围和观察次数。
- 对于确实含义相同的候选词,选择
加入词典并确认。 - 对于错误的候选词,选择
拒绝并确认。
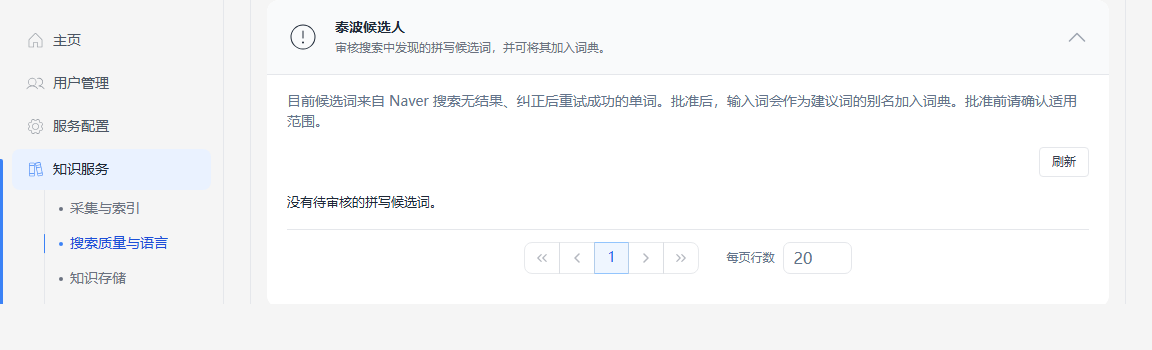
目前的候选词来自 Naver 搜索无结果时更正搜索成功的词。批准后,输入的词会登记为建议词的同义词,并更新词典列表。候选词不会自动批准,请审核其应用范围和含义。
即将推出的功能
搜索词纠正的独立规则管理卡片目前尚不可用。拼写错误候选词审核和词典登记可以使用。