'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
上下文搜索(AI 搜索)
即使关键词不完全一致,也能理解语义并搜索到相关文件。
使用之前
需要在管理员设置中启用知识索引。只有已完成索引的文件才会成为上下文搜索的对象。
上下文搜索会把文件的语义转换为向量进行存储,因此需要在本地准备好负责这一转换的嵌入模型。
索引和搜索都在工作空间内部处理,文件不会流出到外部。
- 嵌入模型:将文本转换为向量的模型。如果有较多中文、韩文等多语言文档,建议使用擅长处理多语言的模型(例如:bge-m3)。
- 要同时查看文档来源,必须已使用该嵌入模型完成索引。
→ 嵌入模型的准备和索引方法:知识索引设置
搜索方法
- 在上方搜索框的左侧菜单中选择“上下文搜索”。
- AI 搜索辅助
点击搜索框右侧的
🪄按钮,可以启用 AI 搜索辅助功能。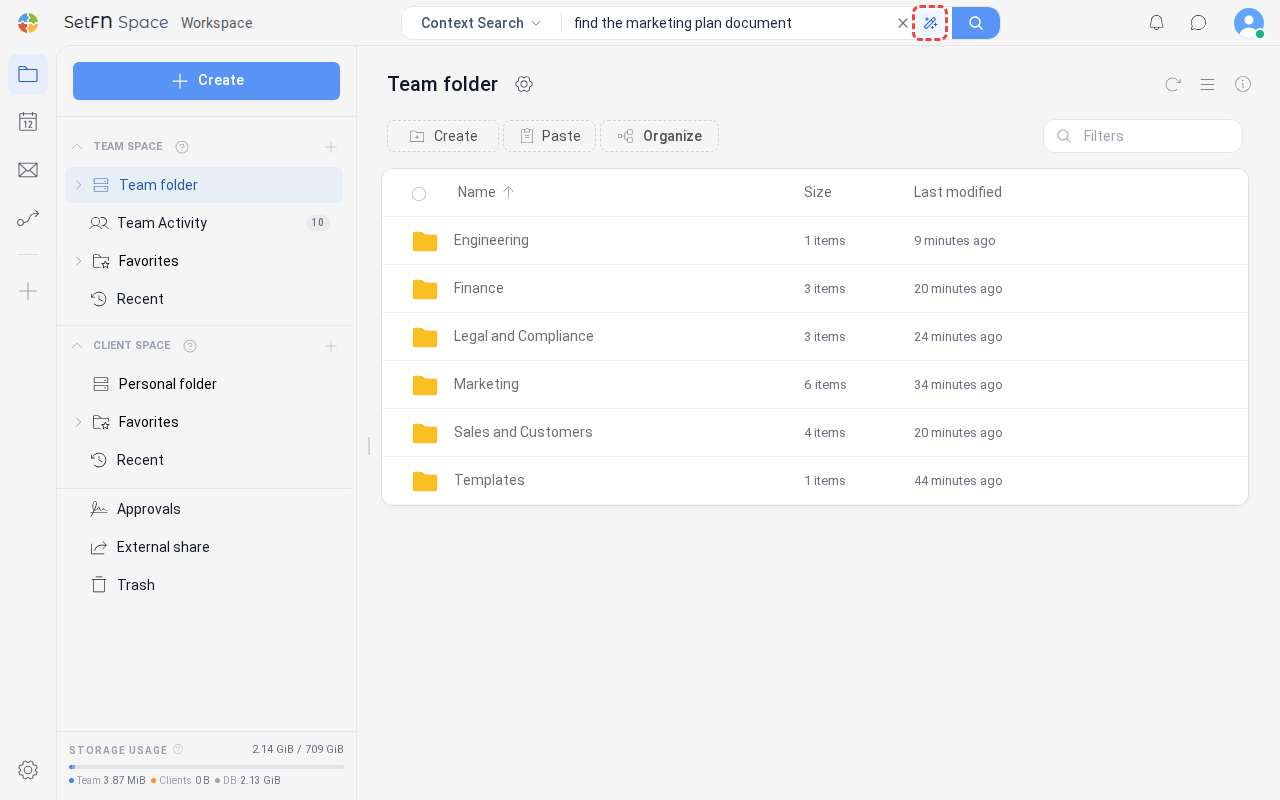
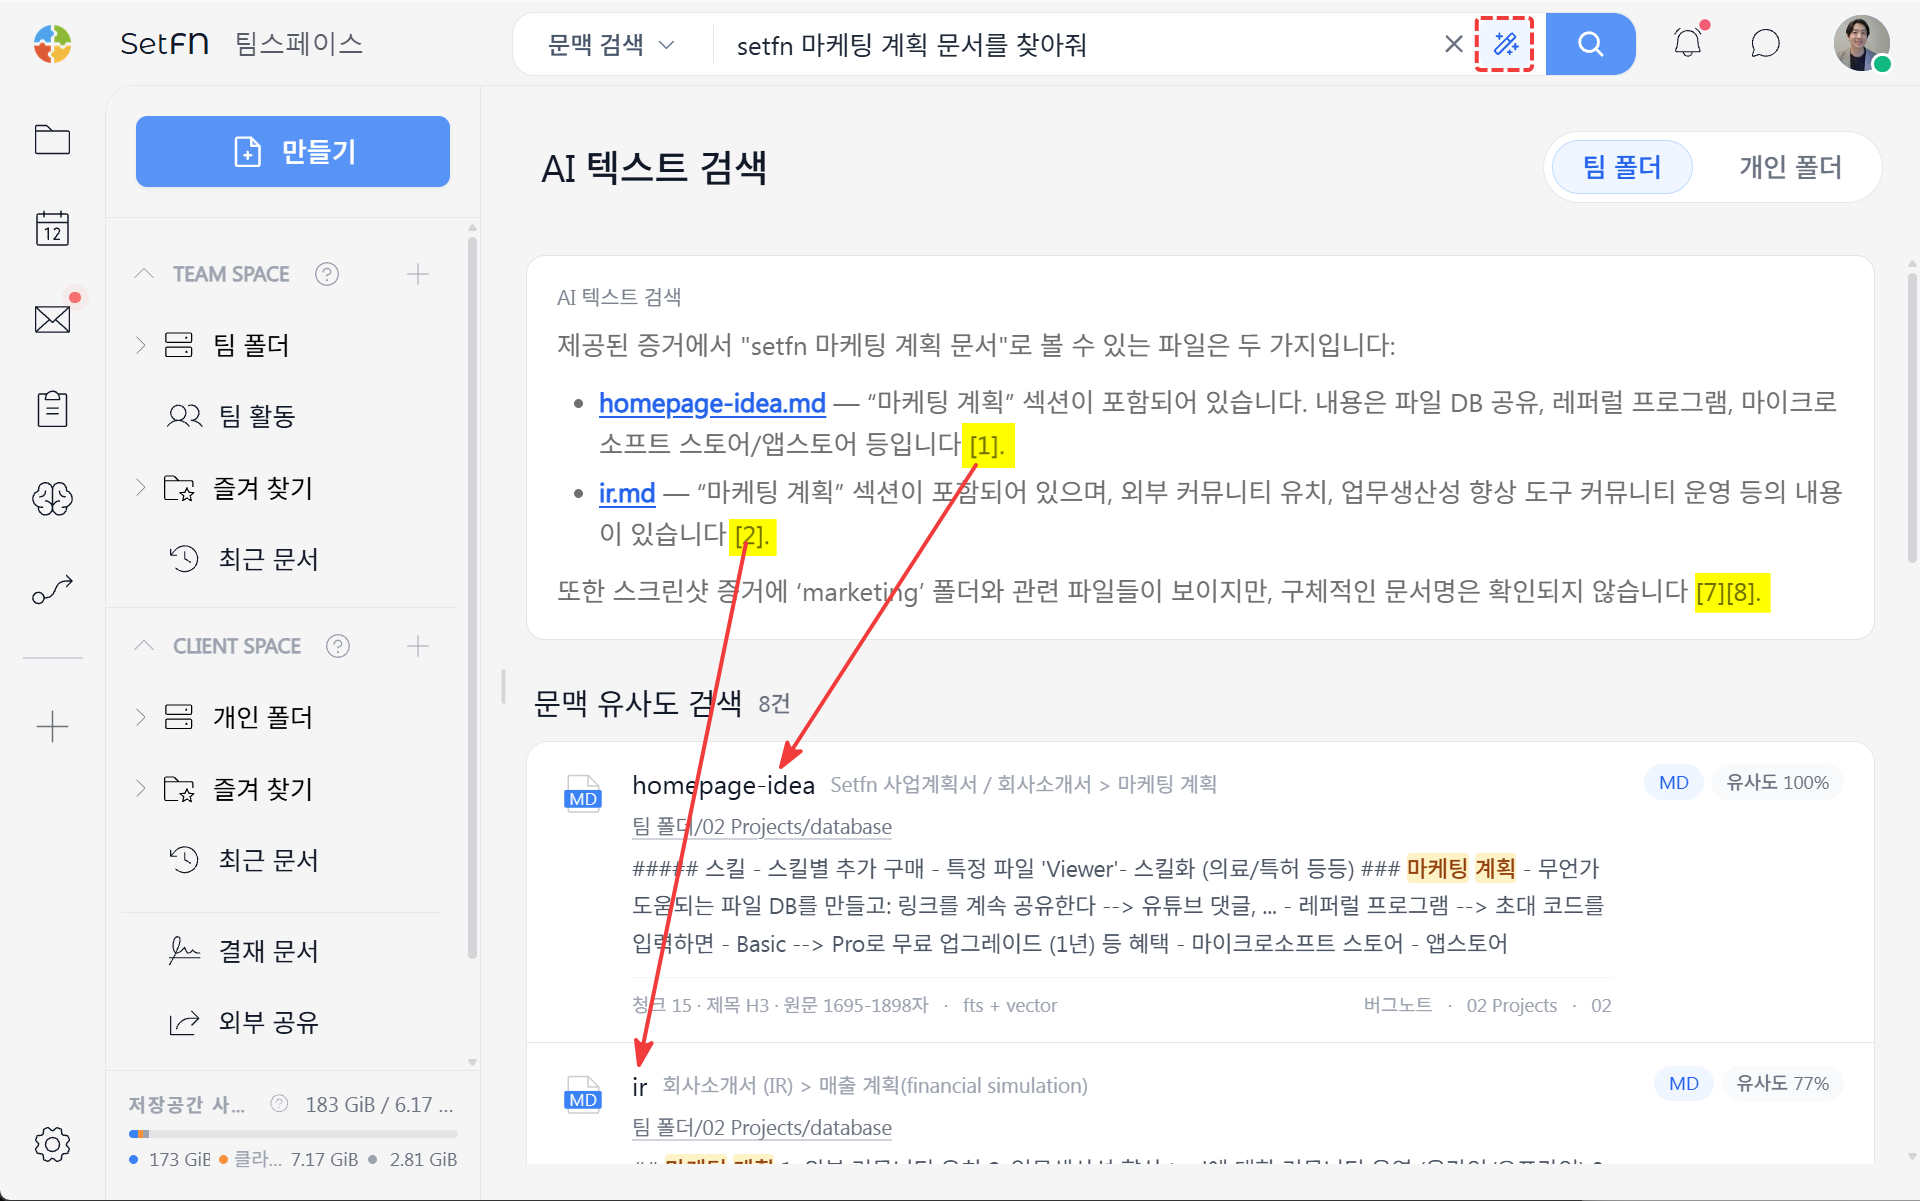
AI 搜索结果
AI 会总结搜索结果,并连同公司内部文档的来源一起告知。
文档来源的数字编号与上下文相似度搜索列出的列表顺序相对应。标示为来源的文档就是 AI 生成答案时所依据的资料。
以实际文档为依据作答(RAG)
上下文搜索不只依赖 AI 的通用知识。它会先在工作空间中找到与问题相关的实际文档,再将其内容作为依据资料传递给 AI,并把答案和来源一起展示。这称为检索增强生成(RAG,Retrieval-Augmented Generation)。
查找实际文档并用于作答的过程分为索引和搜索两个阶段。
索引(事先准备)
- 将文件按语义单元(块)切分。
- 嵌入模型(例如:bge-m3)把每个块转换为向量。
- 将转换后的向量保存到工作空间的向量存储中。
搜索(提问时)
- 输入的问题也用同一个嵌入模型转换为向量。
- 按相似度顺序找出与问题向量最接近的块。
- 将找到的块作为依据资料传递给 AI。
- AI 基于这些资料总结出答案,并把使用过的块标示为文档来源。
得益于这种结构,即使不输入精确的关键词,也能找到语义相近的公司内部文档。AI 答案会一并显示实际参考的文档来源,因此可以直接打开并核对答案的依据。
问题和文档必须用同一个嵌入模型向量化才能相互比较。因此,更换索引时使用的嵌入模型后,需要重新索引全部文件。
与常规搜索的区别
| 常规搜索 | 上下文搜索 | |
|---|---|---|
| 方式 | 关键词文本匹配 | 基于 AI 嵌入的语义搜索 |
| 搜索词 | 需要精确的词语 | 可使用自然语言、相近表达 |
| 对象 | 文件名·文件内容 | 已做知识索引的文件 |
| 前提条件 | 无 | 本地嵌入模型、知识索引 |
注意事项
- 刚完成索引后,搜索结果可能有遗漏。请在索引完成后再搜索。
- AI 的搜索结果会因提问方式而有所不同。请尝试用多种方式提问。
- 嵌入模型的性能和语言支持范围决定搜索质量。
- 更换嵌入模型后与现有索引不兼容,需要全部重新索引。