'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
设置模型与运行时
介绍如何连接 SetFN 要使用的本地推理运行时和外部 AI 模型,并按功能设置模型优先级。
开始之前
- 所需权限:管理员
- 确认运行时所在服务器的地址以及是否使用认证。
- 如果运行时位于其他服务器,SpaceBuilder 服务器必须能够访问该地址和端口。
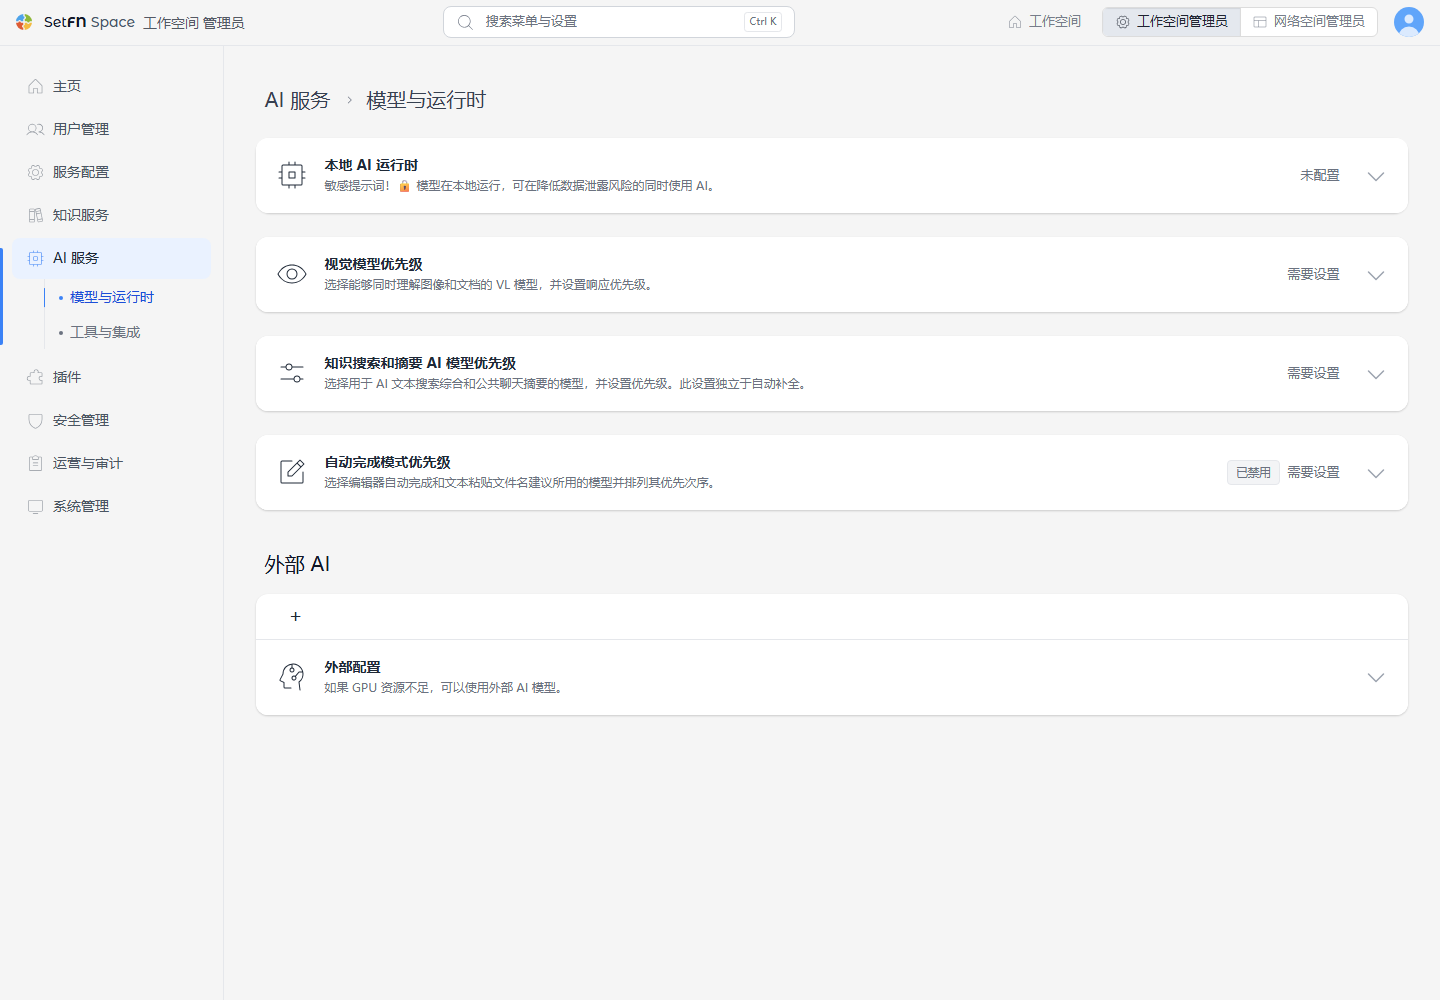
打开模型与运行时
- 访问管理员页面。
- 在左侧菜单中选择
AI 服务。 - 选择
模型与运行时。
本地 AI 运行时
可以将 SetFN 工作空间连接到在本地环境中运行的推理运行时,以使用 AI 功能。
运行时设置
推理运行时可以从以下选项中选择一个。
| 运行时 | 说明 | 默认端点示例 |
|---|---|---|
| Ollama | 使用本地安装的 Ollama 模型。 | http://localhost:11434 |
| LM Studio | 使用通过 LM Studio 本地服务器功能运行的模型。 | http://localhost:1234 |
| ONNX (OpenAI API) | 连接到提供 OpenAI 兼容 API 的 ONNX 运行时服务器。 | http://localhost:8000 |
| Docker Model Runner | 使用在 Docker 环境中运行的模型运行时。 | http://localhost:12434 |
主运行时与子运行时配置
主运行时用作默认推理连接。在 Enterprise 或更高等级的许可证下,可以选择 添加子运行时 登记最多 10 个辅助运行时。每个运行时分别保存类型、端点、显示名称和 API Token,并可以在页面中查看连接状态。
端点设置
输入所选运行时的服务器地址。
- 在同一台设备上运行运行时时,使用
localhost地址。(例:http://localhost:11434) - 在其他服务器上运行运行时时,输入该服务器的 IP 或域名以及端口。
- 输入的端点必须能够从安装 SpaceBuilder 的设备访问。
API Token 设置
API Token 为可选项。
仅当所选运行时启用了认证时才输入 API Token。如果是不使用认证的本地运行时,可以留空保存。
安装新模型
输入要使用的模型名称并按下 安装 按钮,所选 AI 运行时就会拉取(pulling)该模型。此功能适用于 Ollama 和 LM Studio;使用 LM Studio 时,请输入模型 ID 或 GGUF/MLX 仓库 URL。使用 Ollama 时,可安装的模型名称和标签可在 Ollama 官方模型库中查看。
例如,在模型名称中输入以下内容,就会自动下载并安装该模型。
gemma4:31b
模型文件可能很大。安装前请确认服务器的存储空间、内存或 GPU 规格。
了解模型特性
Ollama 等本地 AI 运行时会用特性标签表示模型支持的功能。每个模型能做的工作不同,请确认是否有符合使用目的的标签。
| 模型特性 | 含义 | 主要用途 |
|---|---|---|
completion | 可以生成接续输入上下文的内容并回答问题的通用文本生成模型。 | 聊天、文档撰写、摘要 |
thinking | 支持在生成回答前分多个步骤分析问题的推理功能。比通用模型更有利于准确判断,但响应时间可能更长。 | 复杂查询、分析、制定计划 |
tool use | 模型可以选择外部工具或函数并构建所需参数。是否实际执行工具取决于连接的功能和权限。 | 代理任务、搜索、调用外部功能 |
vision | 可以在理解文本的同时理解图像输入的 VL(Vision-Language)模型。 | 图像描述、扫描文档和屏幕分析 |
embedding | 将句子含义转换为数值向量的嵌入专用模型。不用于生成一般聊天回答。 | 知识索引、相似文档搜索、RAG |
cloud | 在 Ollama Cloud 而不是本地设备上运行的模型。注册 Ollama Cloud 并完成运行时认证后即可使用。 | 本地资源不足的环境、运行大规模模型 |
有些模型同时支持多种特性。例如同时支持 vision 和 completion 的模型可以在理解图像后用文本回答。而 embedding 模型则在知识存储设置中被选为搜索用模型。
cloud 模型不会将模型文件全部下载到本地,而是在远程运行。因此需要互联网连接和 Ollama Cloud 账户认证,可用模型和使用限额可能因所注册服务的政策而异。
已安装模型
查看所选本地 AI 运行时中可用的模型列表。
在已安装模型列表中,可以查看各模型的名称、参数数量、大小、安装日期等。使用 Ollama 时,不再使用的模型可以用 删除 按钮移除。
视觉模型优先级
选择能够同时理解图像和文档的 VL(Vision-Language)模型,并设置响应优先级。
- 从已启用的模型中选择用于视觉输入的模型。
- 所选模型按优先级顺序调用。
- 可以用上下按钮调整调用顺序。
知识搜索·摘要 AI 模型优先级
设置汇总知识搜索结果或生成公开聊天摘要(digest)时使用的模型和调用顺序。
可用模型
从已启用的模型中选择用于知识搜索和摘要的模型,添加到优先级列表。视觉输入用的 VL 模型和嵌入专用模型不在可选范围内。
选中优先级
添加的模型可以用上下按钮更改调用顺序。如果排在前面的模型不可用(例如运行时更改或连接失败),会自动切换到下一顺位的模型。
自动选择策略
确定优先级列表为空或列表中的模型全部不可用时适用的选择标准。
| 策略 | 说明 |
|---|---|
| 响应速度优先 | 优先选择能够快速响应的模型。 |
| 均衡 | 同时考虑响应速度和结果质量。 |
| 质量优先 | 优先选择摘要结果质量高的模型。摘要重要内容时推荐使用。 |
编辑器 AI 自动完成
可以设置在 MD 编辑器中撰写文档时,由 AI 建议下一句或接续的内容。
在 自动完成模型优先级 卡片中开启 启用自动完成 后,编辑 .md 文档时,AI 会根据光标位置和周围上下文建议撰写候选。可用于会议记录、报告、备忘录、技术文档等需要连续撰写文本的场景。
关于 AI 自动完成在实际 Markdown 编辑器中如何显示,请参考查看和编辑 Markdown、文本文件的 AI 自动完成 部分。
模型选择方式
编辑器 AI 自动完成使用的模型可以通过两种方式选择。
| 选择方式 | 说明 |
|---|---|
| 自动选择 | 选中优先级 为空时,自动选择符合 自动选择策略 的模型。 |
| 特定模型 | 按 选中优先级 的顺序使用从 可用模型 中添加的模型。 |
要使用特定模型,必须先在本文的已安装模型设置中安装或连接本地 AI 模型。
自动选择策略
使用自动选择时,可以按以下标准确定模型选择策略。
| 策略 | 说明 | 适用场景 |
|---|---|---|
| 响应速度优先 | 优先使用能够快速响应的模型。 | 简短备忘、实时撰写辅助 |
| 均衡 | 同时考虑速度和质量。 | 一般文档撰写、团队共用默认值 |
| 质量优先 | 优先使用能给出更高质量回答的模型。 | 报告、提案、长文档草稿 |
保存设置
在各卡片中修改值后,选择该卡片的 保存。更改运行时端点后会显示重启服务器的提示,选择 重新启动服务器 后生效。保存后,AI 聊天、基于文档的问答、知识索引等 AI 功能即可使用所设置的运行时和模型。
注意事项
- ONNX 和 Docker Model Runner 不支持
安装新模型。请先在运行时中下载或加载要使用的模型。 - 如果运行时已关闭或端点地址不正确,SetFN 将无法调用模型。
- 请确认防火墙或网络策略没有阻止端口访问。