'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
ファインチューニングの紹介
ファインチューニングプラグインは、LLaMA Factoryをベースに、ローカルLLM(sLLMなどの小型言語モデルを含む)を目的のドメインに合わせてトレーニングする機能です。元データの前処理から、トレーニング、評価、チャットテスト、結果モデルのエクスポートまで、すべての工程を1つの画面で処理できます。このプラグインの画面は現在韓国語で表示されるため、このドキュメントのラベルは翻訳したものです。
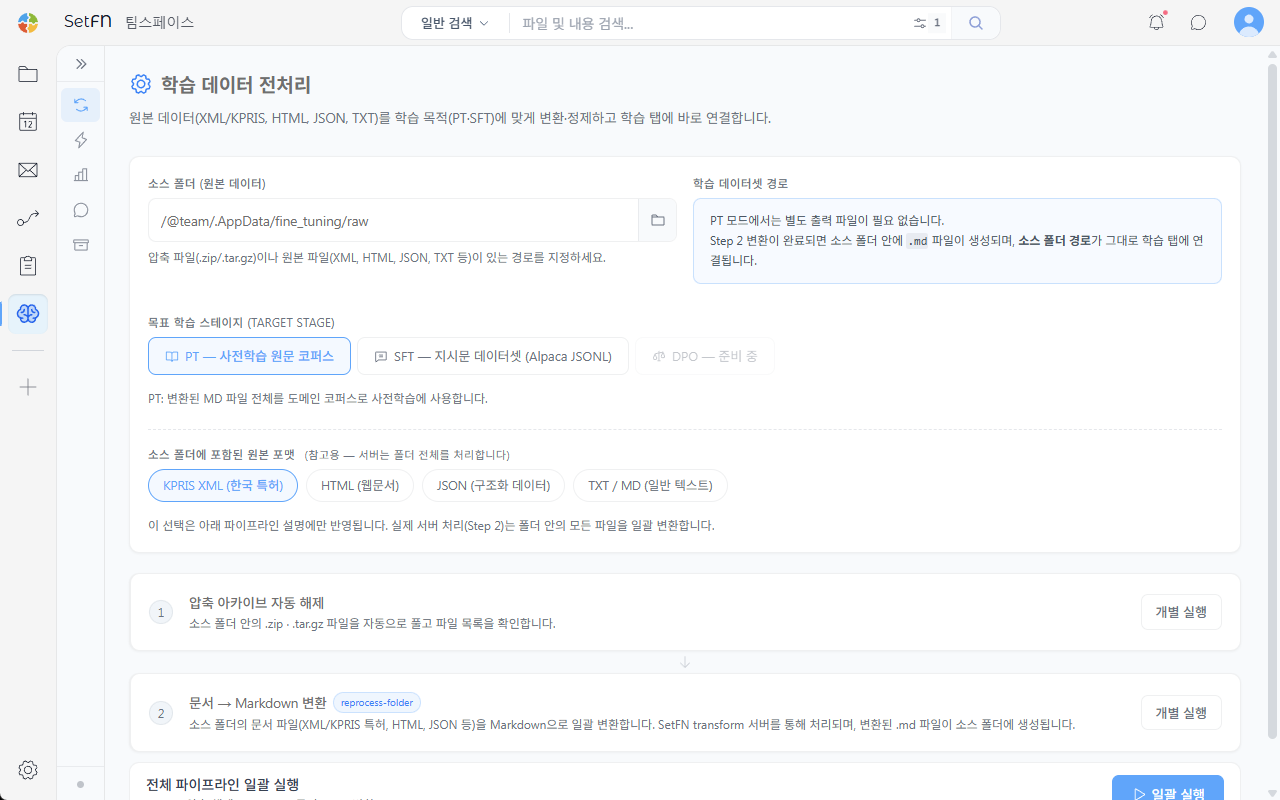
作業の流れ
ファインチューニングは、次の5つの段階で進めます。
| 段階 | 説明 |
|---|---|
| 前処理 | 元データ(XML、MD、HTML、JSON、TXT)を、トレーニングの目的(PT・SFT)に合わせて変換・整形します |
| トレーニング | データセット、モデル、トレーニング方法(STAGE)を指定して、ファインチューニングを実行します |
| 評価 | 完了したトレーニングRunの結果を点検し、データセットの有効性を再検査します |
| チャットテスト | トレーニングしたモデルと直接会話して、結果を確認します |
| エクスポート | トレーニングRunを管理し、結果の重みを次のファインチューニングのBase Modelとしてつなげます |
注意事項
- トレーニングにはGPUリソースが必要です。サーバーの仕様を事前に確認してください。
- トレーニング中は、停止するまでバックグラウンドで処理が続きます。