'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
トレーニングデータの前処理
元データ(XML、HTML、JSON、TXT)をトレーニングの目的(PT・SFT)に合わせて変換・整形し、トレーニングタブに直接つなげます。
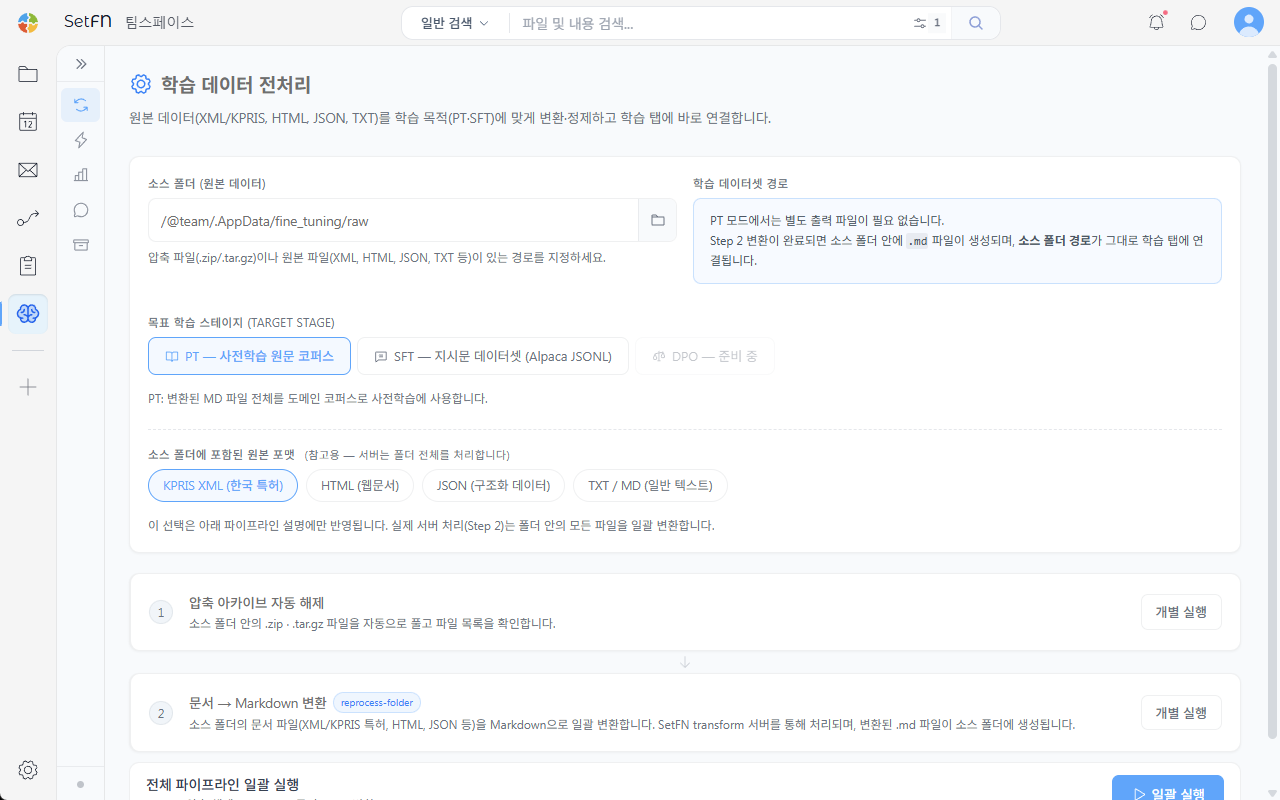
ソースフォルダの指定
圧縮ファイル(.zip/.tar.gz)や元のファイル(XML、HTML、JSON、TXTなど)があるソースフォルダのパスを指定します。デフォルトのパスは/@team/.AppData/fine_tuning/rawです。
目標トレーニングステージの選択
変換するデータの目的を選択します。
| ステージ | 説明 |
|---|---|
| PT — 事前学習用の原文コーパス | 変換されたMDファイル全体を、ドメインコーパスとして事前学習に使用します |
| SFT — 指示文データセット(Alpaca JSONL) | instruction/input/output形式の指示文データセットに変換します |
| DPO | まだ対応していません |
PTモードでは、別途出力ファイルを用意する必要はありません。変換が完了するとソースフォルダの中に.mdファイルが作成され、ソースフォルダのパスがそのままトレーニングタブに引き継がれます。
SFTを選択すると、最終出力ファイルのパス(JSONL)が表示されます。空欄のままにすると、ソースフォルダ内にdataset.jsonlとして保存されます。
ソースフォルダに含まれる元データの形式
ソースフォルダにどの形式の元データが混在しているかを、参考用に表示します。KIPRIS XML(韓国特許)、HTML(Web文書)、JSON(構造化データ)、TXT/MD(一般的なテキスト)の中から選択でき、この選択は下のパイプラインの説明にのみ反映されます。実際のサーバー処理では、フォルダ内のすべてのファイルを一括で変換します。
パイプラインの実行
PTは2つ、SFTは3つの段階で構成されており、各段階は個別に実行することも、まとめて一括で実行することもできます。
- 圧縮アーカイブの自動展開:ソースフォルダ内の.zip・.tar.gzファイルを自動的に展開し、ファイルの一覧を確認します。
- 文書 → Markdown変換:ソースフォルダの文書ファイル(XML、HTML、JSONなど)を、Markdownに一括で変換します。変換された.mdファイルが、ソースフォルダに作成されます。
- Alpaca JSONL生成(SFT用):SFTを選択した場合にのみ表示されます。.md・.txtファイルを、instruction/input/output構造のAlpaca JSONLに変換します。
Run Full Pipeline in Batchの一括実行ボタンを押すと、すべての段階が順番に実行されます。完了したらトレーニング(Train)タブに接続を選択し、データセットをトレーニングタブに渡します。