'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
トレーニング
前処理済みのデータセット、ベースモデル、トレーニング方法(STAGE)を指定して、ファインチューニングを実行します。
1. トレーニングデータセットの選択
元のソースフォルダではなく、すでにトレーニング用に整理されたデータセットフォルダを選択します。Team AppData Training Set、Personal AppData Training Setの中から選ぶか、Custom...のパスを直接入力します。フォルダを選択すると、その下ですぐに検証が行われ、トレーニングに使用できるファイルの数が表示されます。
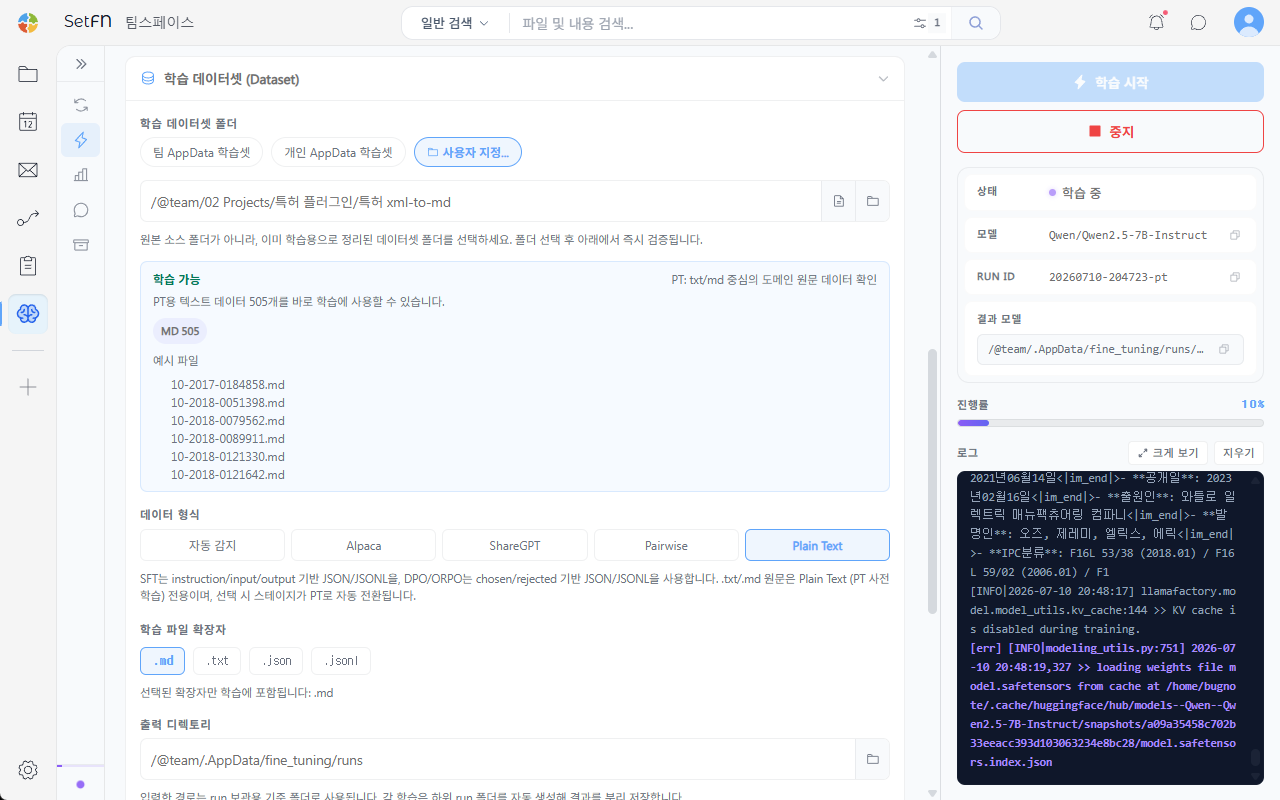
データ形式
自動検出、Alpaca、ShareGPT、Pairwise、Plain Textの中から選択します。
- SFTでは、instruction/input/outputベースのJSON/JSONLを使用します。
- DPO/ORPOでは、chosen/rejectedベースのJSON/JSONLを使用します。
- .txt/.mdの原文は、Plain Text(PT事前学習)専用です。選択すると、ステージがPTに自動的に切り替わります。
トレーニングファイルの拡張子と出力ディレクトリ
トレーニングに含めるファイルの拡張子(.md、.txt、.json、.jsonl)を選択し、トレーニング結果を保存する出力ディレクトリを指定します。実行結果は、Run番号ごとのサブフォルダとして自動的に作成され、それぞれ分けて保存されます。
2. モデルの選択
HUGGINGFACE MODEL IDを直接入力するか、検索欄でモデルを検索します。Qwen2.5-7B-Instruct、Qwen2.5-14B-Instruct、Gemma-2-9B-It、Llama-3.1-8B-Instruct、DeepSeek-R1-14B、DeepSeek-R1-8Bの中から、すばやく選択することもできます。
CHAT TEMPLATEは、デフォルトでモデル名に基づく自動検出(推奨)を使用します。正しく動作しない場合にのみ、手動で選択してください。
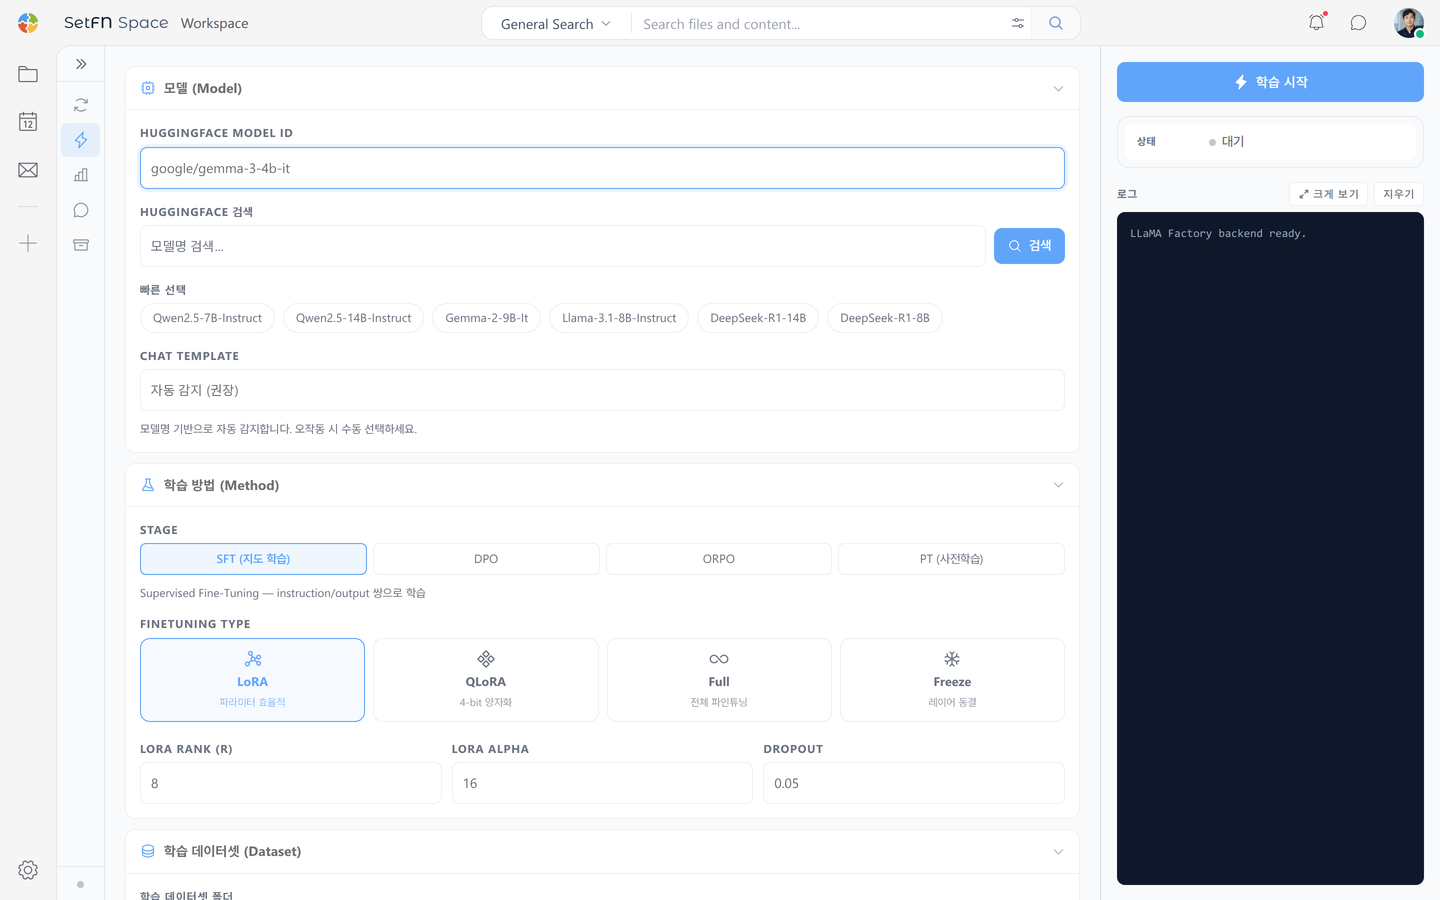
3. トレーニング方法(STAGE)とファインチューニング方式の選択
| STAGE | 説明 |
|---|---|
| SFT(教師あり学習) | instruction/input/outputデータで、特定のタスクを学習させます |
| DPO | chosen/rejectedデータで、選好を学習させます |
| ORPO | DPOに似た、選好ベースのアライメント方式です |
| PT(事前学習) | Continued Pre-Training。純粋なテキストで、ドメイン知識を学習させます |
FINETUNING TYPEは、LoRA、QLoRA(4-bit量子化)、Full(フルファインチューニング)、Freeze(レイヤー凍結)の中から選択します。LoRA RANK、LORA ALPHA、DROPOUTなど、詳細なハイパーパラメータも調整できます。
4. トレーニングの開始
Start Trainingボタンをクリックすると、トレーニングが開始されます。右側のパネルで、ステータス、モデル、RUN ID、結果モデルのパス、進行率をリアルタイムで確認でき、ログもあわせて出力されます。トレーニングを止めるには、Stopボタンをクリックします。
注意事項
- データ形式と目標ステージが合っていないと、トレーニングが開始されない場合があります。
- トレーニング中は、同じRunの設定を変更できません。