'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
チャットテスト
トレーニングが完了したモデルを読み込むか接続し、直接会話しながらファインチューニングの結果を確認できます。
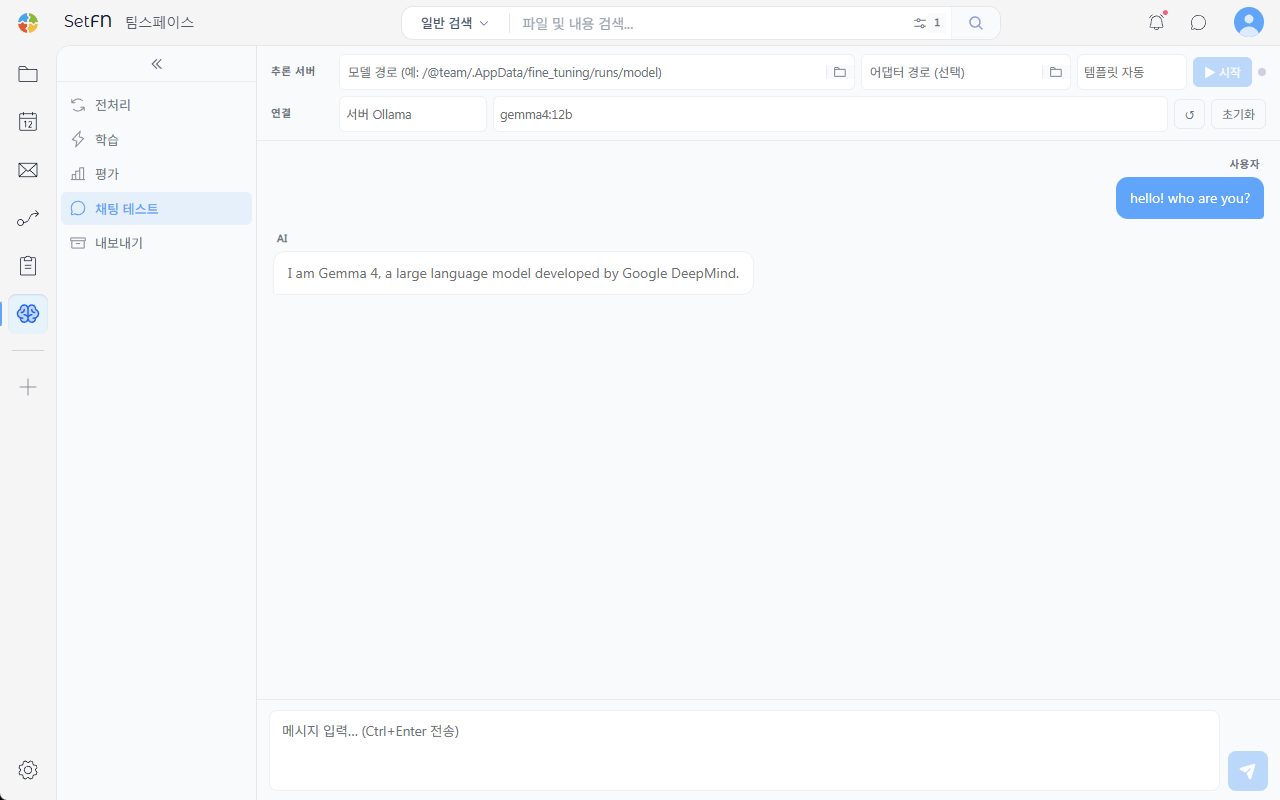
推論サーバーでモデルを読み込む
トレーニングの結果モデルを直接読み込んでテストします。
- モデルパス:テストするモデルのパスを入力します(例:
/@team/.AppData/fine_tuning/runs/model) - アダプターパス(任意):LoRAなどでトレーニングしたアダプターの重みだけを別途使用する場合に、パスを指定します
- テンプレート:デフォルトで自動検出されます
パスを入力してからStartボタンをクリックすると、推論サーバーが起動し、Connectが推論サーバーに切り替わります。
Ollamaサーバーに接続
すでにOllamaに登録されているモデルで、すぐにテストすることもできます。
ConnectでサーバーのOllamaまたはローカルのOllama(自分のPC)を選択します。- 更新ボタン(
↺)でモデルの一覧を読み込みます。 - テストするモデル(例:
gemma4:12b)を選択します。
カスタムAPIを選択した場合は、APIのアドレスとモデル名を直接入力します。Resetボタンをクリックすると、会話の内容が消去されます。
会話で結果を確認
下部の入力欄にメッセージを入力し、Ctrl+Enter(または送信ボタン)で送信すると、ユーザーのメッセージとAIの応答がチャット形式で表示されます。トレーニングの意図に合った質問をして、応答の品質と形式を確認します。
注意事項
- PT(事前学習)だけを完了したモデルは、指示に従う会話よりも、文章の続きを書く形式の応答をする場合があります。指示に従う会話の品質を確認するには、SFTまで進めたモデルでテストしてください。
- モデルパスが空の場合は
Startを選択できません。アダプターを使う場合も、モデルパスをあわせて指定します。