'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
モデル・ランタイムを設定する
SetFNで使用するローカル推論ランタイムと外部AIモデルを接続し、機能ごとのモデル優先順位を設定する方法を説明します。
始める前に
- 必要な権限:管理者
- ランタイムを実行するサーバーのアドレスと、認証を使用するかどうかを確認します。
- ランタイムが別のサーバーにある場合は、SpaceBuilderサーバーからそのアドレスとポートにアクセスできる必要があります。
モデル・ランタイムを開く
- 管理者ページにアクセスします。
- 左側のメニューで
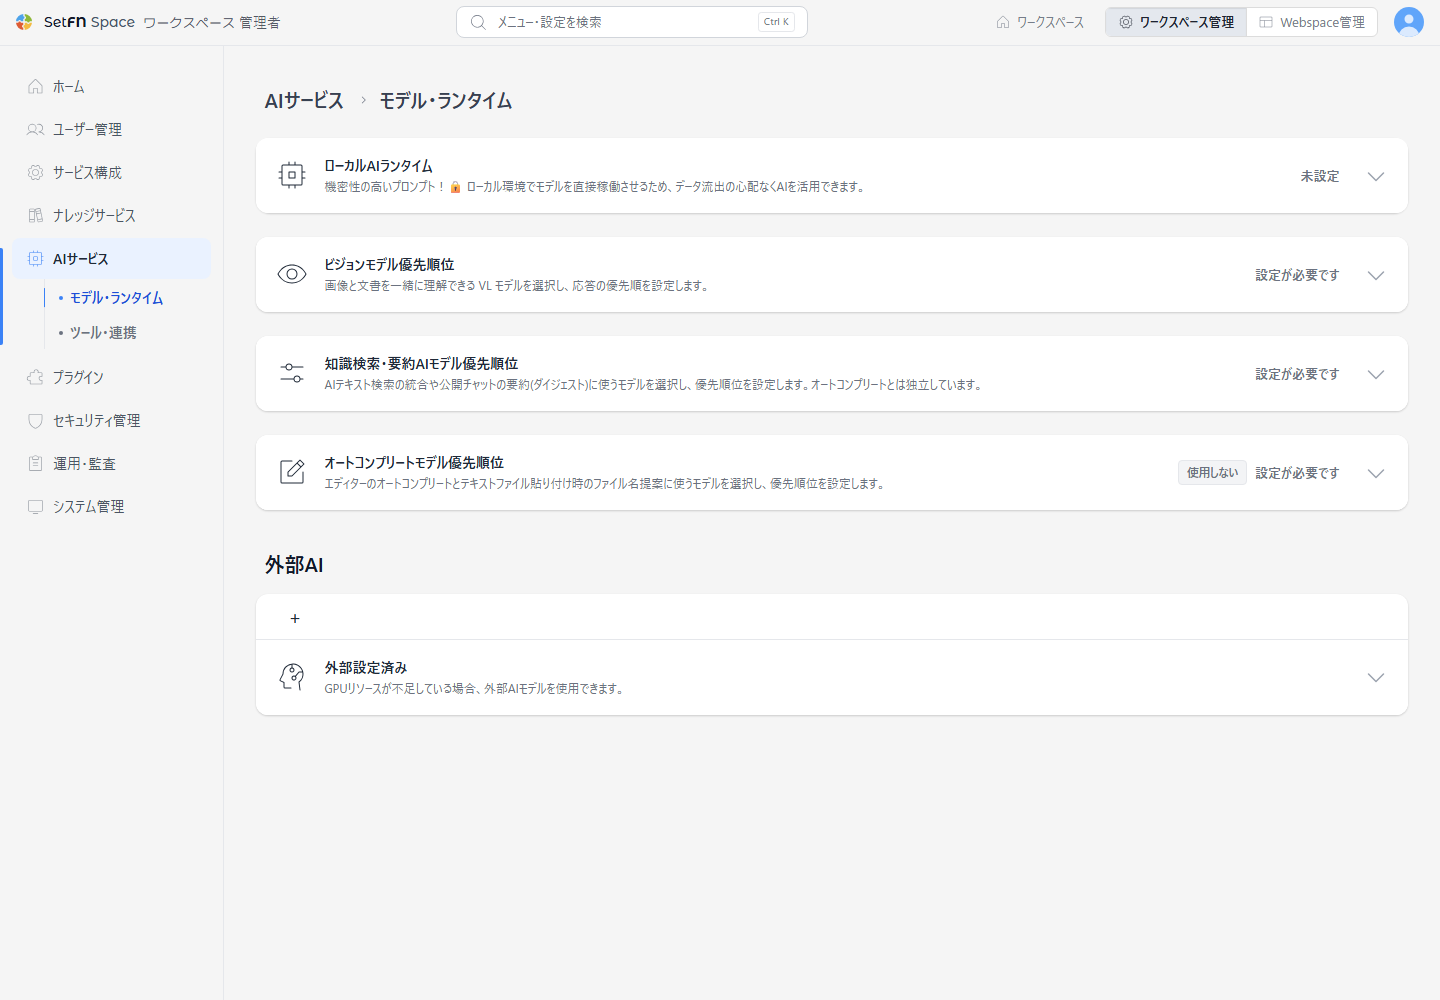
AIサービスを選択します。 モデル・ランタイムを選択します。
ローカルAIランタイム
SetFNワークスペースを、ローカル環境で実行中の推論ランタイムに接続してAI機能を使用できます。
ランタイム設定
推論ランタイムは、次のいずれかを選択できます。
| ランタイム | 説明 | デフォルトのエンドポイント例 |
|---|---|---|
| Ollama | ローカルにインストールされたOllamaモデルを使用します。 | http://localhost:11434 |
| LM Studio | LM Studioのローカルサーバー機能で実行したモデルを使用します。 | http://localhost:1234 |
| ONNX (OpenAI API) | OpenAI互換APIを提供するONNXランタイムサーバーに接続します。 | http://localhost:8000 |
| Docker Model Runner | Docker環境で実行中のモデルランタイムを使用します。 | http://localhost:12434 |
メイン・サブランタイムの構成
メインランタイムは、基本の推論接続として使用されます。Enterprise以上のライセンスでは、サブランタイム追加を選択して補助のランタイムを最大10個まで登録できます。各ランタイムは、種類、エンドポイント、表示名、API Tokenを個別に保存し、画面で接続状態を確認できます。
エンドポイント設定
選択したランタイムのサーバーアドレスを入力します。
- 同じ機器でランタイムを実行する場合は、
localhostのアドレスを使用します。(例:http://localhost:11434) - 別のサーバーでランタイムを実行する場合は、そのサーバーのIPまたはドメインとポートを入力します。
- 入力したエンドポイントは、SpaceBuilderをインストールした機器からアクセスできる必要があります。
API Token設定
API Tokenは任意の項目です。
選択したランタイムで認証を有効にした場合にのみ、API Tokenを入力します。認証を使用しないローカルランタイムの場合は、空欄のまま保存できます。
新しいモデルをインストール
使用するモデル名を入力してインストールボタンを押すと、選択したAIランタイムがモデルを取得します(pulling)。この機能はOllamaとLM Studioで使用でき、LM StudioではモデルIDまたはGGUF/MLXリポジトリURLを入力します。Ollamaを使用する場合、インストールできるモデル名とタグは、Ollama公式モデルライブラリで確認できます。
たとえば、モデル名に次のように入力すると、そのモデルを自動的にダウンロードしてインストールします。
gemma4:31b
モデルファイルは容量が大きい場合があります。インストールする前に、サーバーの保存領域とメモリまたはGPUの仕様を確認してください。
モデルの特性を理解する
OllamaなどのローカルAIランタイムは、モデルが対応する機能を特性タグとして表示します。モデルによってできる作業が異なるため、使用目的に合ったタグがあるかどうかを確認してください。
| モデルの特性 | 意味 | 主な用途 |
|---|---|---|
completion | 入力された文脈に続く内容を生成し、質問に答えることができる一般的なテキスト生成モデルです。 | チャット、文書作成、要約 |
thinking | 回答を作成する前に、複数の段階で問題を分析する推論機能に対応しています。一般的なモデルより正確な判断に向いていますが、応答時間が長くなる場合があります。 | 複雑な質問、分析、計画の立案 |
tool use | モデルが外部のツールや関数を選択し、必要な引数を構成できます。実際にツールを実行するかどうかは、接続されている機能と権限によって異なります。 | エージェント作業、検索、外部機能の呼び出し |
vision | テキストとあわせて画像の入力を理解できるVL(Vision-Language)モデルです。 | 画像の説明、スキャン文書や画面の分析 |
embedding | 文の意味を数値ベクトルに変換する埋め込み専用のモデルです。一般的なチャットの回答を生成する用途ではありません。 | ナレッジインデックス作成、類似文書の検索、RAG |
cloud | ローカルの機器の代わりに、Ollama Cloudで実行されるモデルです。Ollama Cloudに登録し、ランタイムの認証を完了している場合に使用できます。 | ローカルのリソースが不足している環境、大規模モデルの実行 |
複数の特性に同時に対応するモデルもあります。たとえば、visionとcompletionの両方に対応していれば、画像を理解したうえでテキストで回答できます。一方、embeddingモデルは、ナレッジストレージの設定で検索用のモデルとして選択します。
cloudモデルは、モデルファイルをすべてローカルにダウンロードせず、リモートで実行します。そのため、インターネット接続とOllama Cloudアカウントの認証が必要であり、使用できるモデルと利用上限は、登録したサービスのポリシーによって異なる場合があります。
インストール済みモデル
選択したローカルAIランタイムで使用できるモデルの一覧を確認します。
インストール済みモデルの一覧では、各モデルの名前、パラメーター数、容量、インストール日などを確認できます。Ollamaでは、使用しなくなったモデルを削除ボタンで削除できます。
ビジョンモデル優先順位
画像と文書をあわせて理解できるVL(Vision-Language)モデルを選択し、応答の優先順位を設定します。
- 有効化されているモデルの中から、ビジョン入力に使用するモデルを選択します。
- 選択したモデルは、優先順位の順に呼び出されます。
- 上下のボタンで呼び出しの順序を調整できます。
知識検索・要約AIモデル優先順位
ナレッジ検索の結果をまとめるときや、公開チャットの要約(ダイジェスト)を作成するときに使用するモデルと、呼び出しの順序を設定します。
使用可能なモデル
有効化されているモデルの中から、ナレッジ検索と要約に使用するモデルを選択して、優先順位の一覧に追加します。ビジョン入力用のVLモデルと埋め込み専用のモデルは、選択の対象から除外されます。
選択された優先順位
追加したモデルは、上下のボタンで呼び出しの順序を変更できます。上位のモデルを使用できない場合(例:ランタイムの変更や接続の失敗)は、次の順位のモデルに自動的に切り替わります。
自動選択ポリシー
優先順位の一覧が空の場合や、一覧のモデルをすべて使用できない場合に適用する選択基準を決めます。
| ポリシー | 説明 |
|---|---|
| 応答速度優先 | すばやく応答できるモデルを先に選択します。 |
| バランス | 応答速度と結果の品質をあわせて考慮します。 |
| 品質優先 | 要約結果の品質が高いモデルを優先します。重要な内容を要約するときに推奨します。 |
エディタAIオートコンプリート
MDエディタで文書を作成するときに、AIが次の文や続きの内容を提案するように設定できます。
オートコンプリートモデル優先順位カードでオートコンプリートを使用をオンにすると、.md文書を編集するときに、カーソルの位置と周囲の文脈をもとにAIが入力候補を提案します。議事録、報告書、メモ、技術文書のように、テキストを続けて書く場面で使用できます。
実際のマークダウンエディタでAIオートコンプリートがどのように表示されるかは、マークダウン、テキストファイルの表示と編集のAIオートコンプリートセクションを参照してください。
モデルの選択方式
エディタAIオートコンプリートで使用するモデルは、2つの方式で選択できます。
| 選択方式 | 説明 |
|---|---|
| 自動選択 | 選択された優先順位が空の場合、自動選択ポリシーに合ったモデルを自動的に選択します。 |
| 特定のモデル | 使用可能なモデルから追加したモデルを、選択された優先順位の順に使用します。 |
特定のモデルを使用するには、先にこのドキュメントのインストール済みモデルの設定で、ローカルAIモデルをインストールまたは接続する必要があります。
自動選択ポリシー
自動選択を使用する場合は、次の基準でモデルの選択ポリシーを決めることができます。
| ポリシー | 説明 | 適した場面 |
|---|---|---|
| 応答速度優先 | すばやく応答できるモデルを優先して使用します。 | 短いメモ、リアルタイムの作成補助 |
| バランス | 速度と品質をあわせて考慮します。 | 一般的な文書作成、チーム共用のデフォルト値 |
| 品質優先 | より品質の高い回答を出せるモデルを優先して使用します。 | 報告書、提案書、長い文書の下書き |
設定の保存
カードごとに値を変更し、そのカードの保存を選択します。ランタイムのエンドポイントを変更するとサーバー再起動の案内が表示され、サーバー再起動を選択すると反映されます。保存すると、AIチャット、文書をもとにした質疑応答、ナレッジインデックス作成などのAI機能で、設定したランタイムとモデルを使用できます。
注意事項
- ONNXとDocker Model Runnerは
新しいモデルをインストールに対応していません。使用するモデルを先にランタイムでダウンロードまたはロードしておきます。 - ランタイムが終了している場合や、エンドポイントのアドレスが正しくない場合、SetFNはモデルを呼び出せません。
- ファイアウォールやネットワークポリシーによって、ポートへのアクセスがブロックされていないことを確認します。