'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
학습
전처리한 데이터셋과 베이스 모델, 학습 방법(STAGE)을 지정해 파인튜닝을 실행합니다.
1. 학습 데이터셋 선택
원본 소스 폴더가 아니라 학습용으로 정리된 데이터셋 폴더를 선택합니다. 팀 AppData 학습셋이나 개인 AppData 학습셋을 고르거나, 사용자 지정...으로 경로를 직접 지정합니다. 폴더를 선택하면 바로 검증되고 학습할 수 있는 파일 개수가 표시됩니다.
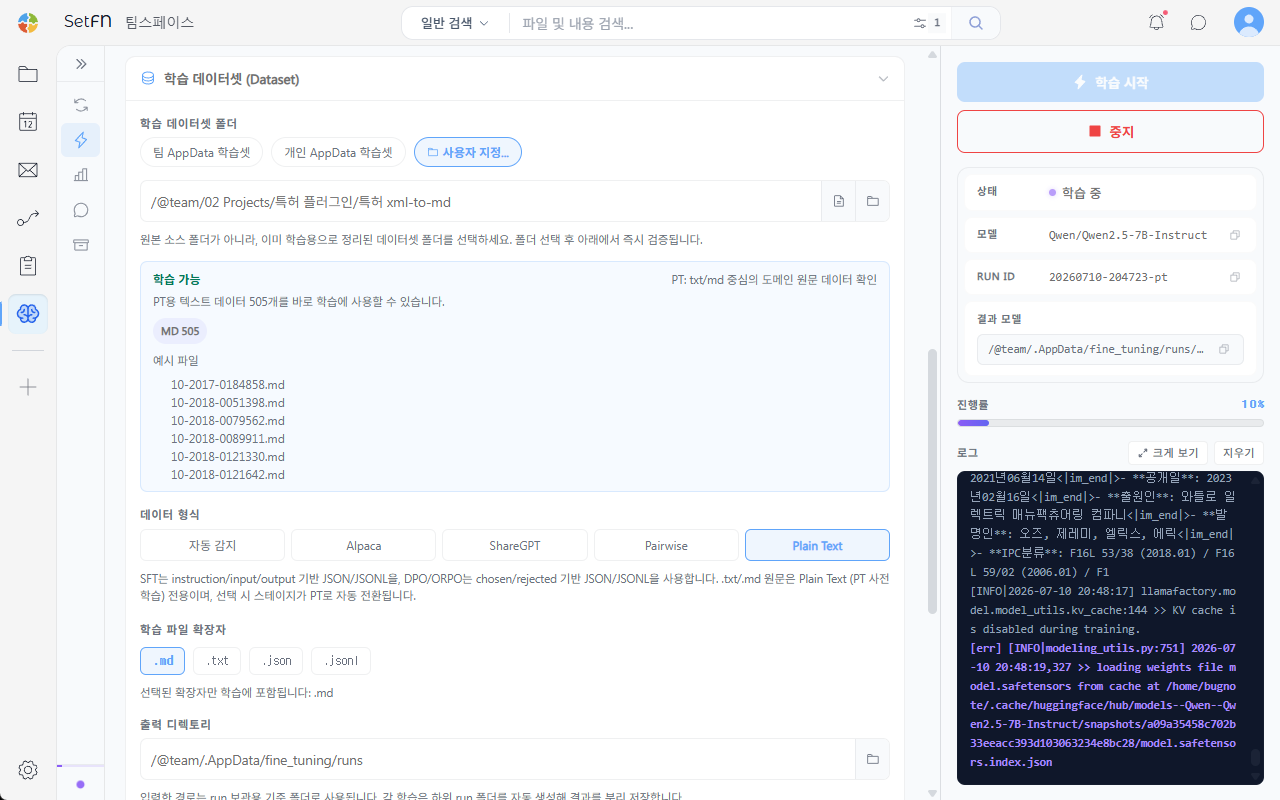
데이터 형식
자동 감지, Alpaca, ShareGPT, Pairwise, Plain Text 중에서 선택합니다.
- SFT는 instruction/input/output 기반 JSON/JSONL을 사용합니다.
- DPO/ORPO는 chosen/rejected 기반 JSON/JSONL을 사용합니다.
- .txt/.md 원문은 Plain Text(PT 사전학습) 전용이며, 선택 시 스테이지가 PT로 자동 전환됩니다.
학습 파일 확장자와 출력 디렉토리
학습에 포함할 파일 확장자(.md, .txt, .json, .jsonl)를 선택하고, 학습 결과를 저장할 출력 디렉토리를 지정합니다. 학습할 때마다 하위 Run 폴더가 만들어져 결과가 따로 저장됩니다.
2. 모델 선택
HUGGINGFACE MODEL ID를 직접 입력하거나 검색창에서 모델을 검색합니다. 빠른 선택에서 Qwen2.5-7B-Instruct, Qwen2.5-14B-Instruct, Gemma-2-9B-It, Llama-3.1-8B-Instruct, DeepSeek-R1-14B, DeepSeek-R1-8B 중 하나를 고를 수도 있습니다.
CHAT TEMPLATE의 기본값은 자동 감지 (권장)로, 모델명을 보고 템플릿을 고릅니다. 제대로 동작하지 않을 때만 직접 선택합니다.
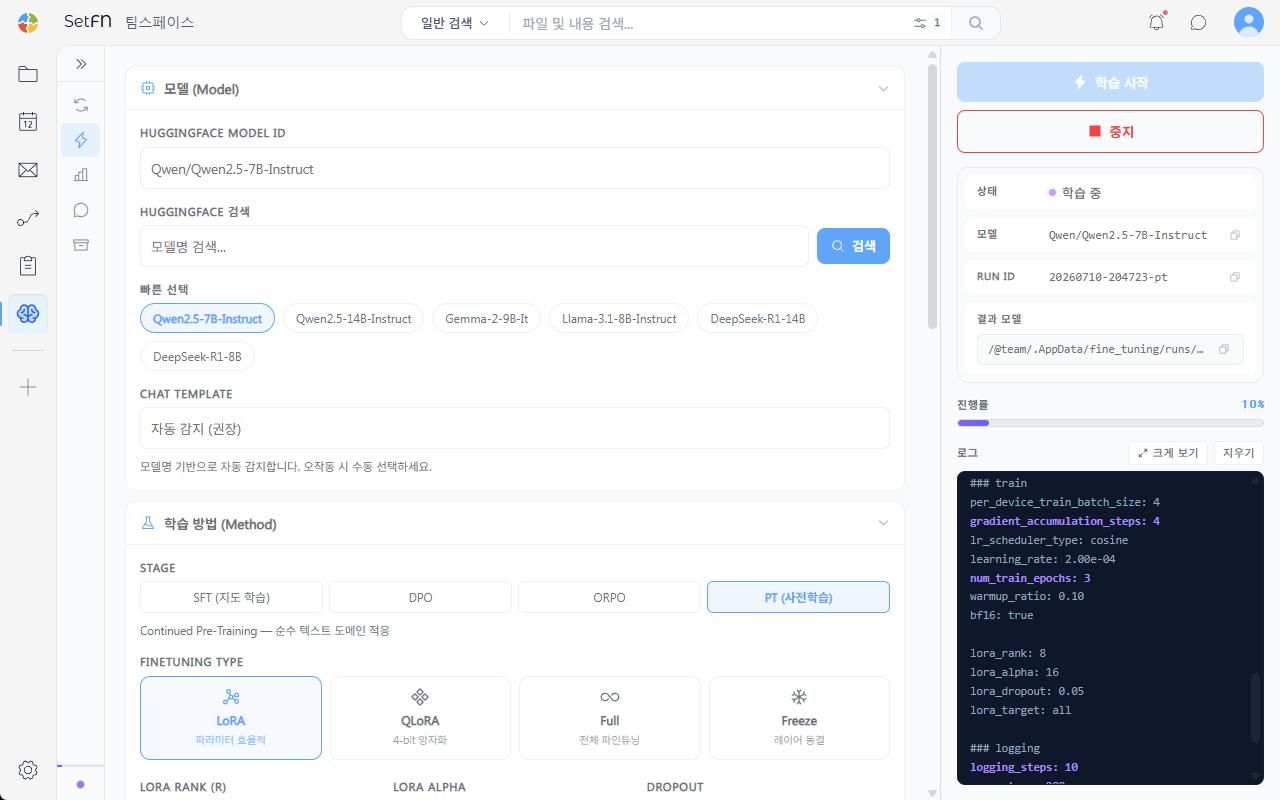
3. 학습 방법(STAGE) 및 파인튜닝 방식 선택
| STAGE | 설명 |
|---|---|
| SFT (지도 학습) | instruction/input/output 데이터로 특정 작업을 가르칩니다 |
| DPO | chosen/rejected 데이터로 선호도를 학습시킵니다 |
| ORPO | DPO와 유사한 선호도 기반 정렬 방식입니다 |
| PT (사전학습) | Continued Pre-Training. 순수 텍스트로 도메인 지식을 학습시킵니다 |
FINETUNING TYPE은 LoRA, QLoRA(4-bit 양자화), Full(전체 파인튜닝), Freeze(레이어 동결) 중에서 선택합니다. LORA RANK (R), LORA ALPHA, DROPOUT 같은 세부 하이퍼파라미터도 조정할 수 있습니다.
4. 학습 시작
학습 시작을 선택하면 학습이 시작됩니다. 오른쪽 패널에 상태, 모델, Run ID, 결과 모델, 진행률과 로그가 실시간으로 표시됩니다. 학습을 멈추려면 중지를 선택합니다.
알아두기
- 데이터 형식과 목표 스테이지가 맞지 않으면 학습이 시작되지 않을 수 있습니다.
- 학습 중에는 같은 Run의 설정을 변경할 수 없습니다.