'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
학습 데이터 전처리
원본 데이터(XML, HTML, JSON, TXT)를 학습 목적(PT·SFT)에 맞게 변환·정제하고 학습 탭에 바로 연결합니다.
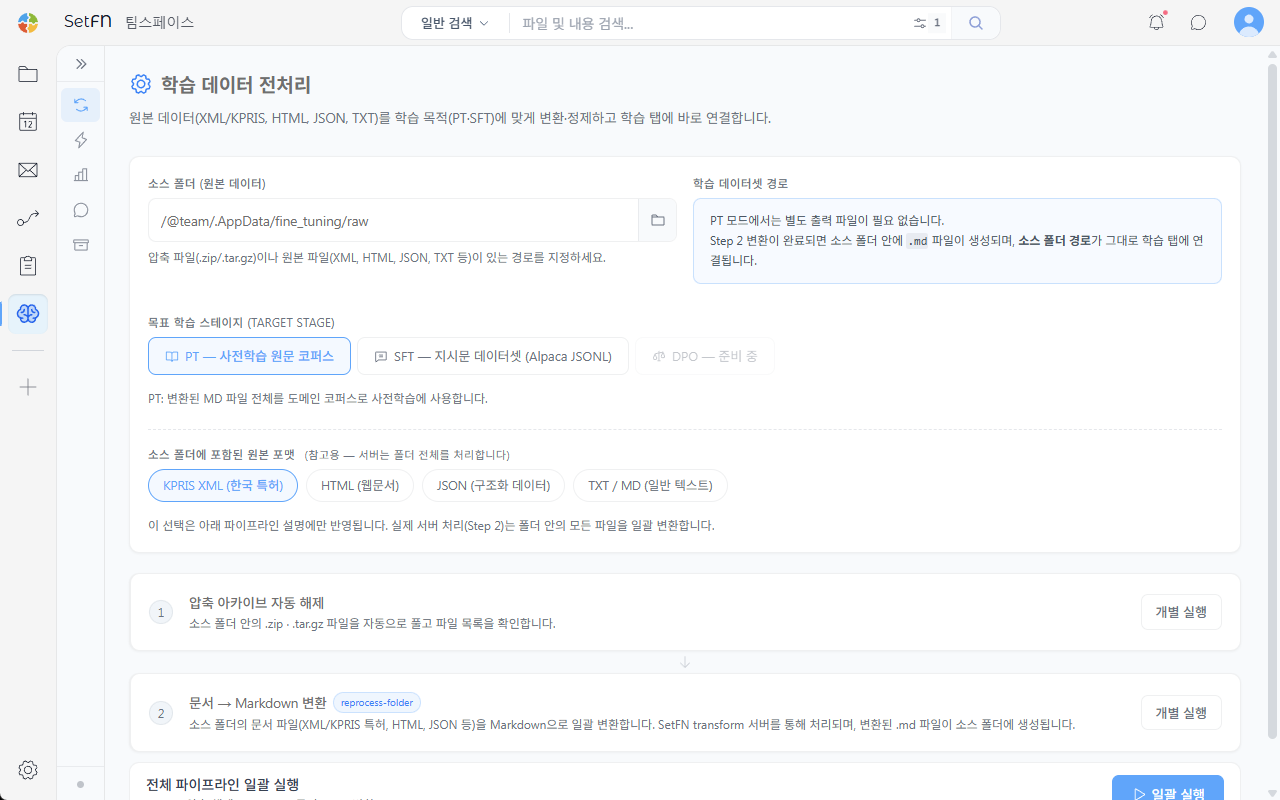
소스 폴더 지정
압축 파일(.zip/.tar.gz)이나 원본 파일(XML, HTML, JSON, TXT 등)이 있는 소스 폴더 경로를 지정합니다. 기본 경로는 /@team/.AppData/fine_tuning/raw입니다.
목표 학습 스테이지 선택
변환할 데이터의 목적을 선택합니다.
| 스테이지 | 설명 |
|---|---|
| PT — 사전학습 원문 코퍼스 | 변환된 MD 파일 전체를 도메인 코퍼스로 사전학습에 사용합니다 |
| SFT — 지시문 데이터셋 (Alpaca JSONL) | instruction/input/output 형식의 지시문 데이터셋으로 변환합니다 |
| DPO | 아직 지원하지 않습니다 |
PT는 별도 출력 파일이 필요 없습니다. 변환이 끝나면 소스 폴더에 .md 파일이 생성되고, 소스 폴더 경로가 그대로 학습 탭에 연결됩니다.
SFT를 선택하면 최종 출력 파일 경로 (JSONL)가 표시됩니다. 비워 두면 소스 폴더 안에 dataset.jsonl로 저장됩니다.
소스 폴더에 포함된 원본 포맷
소스 폴더에 어떤 형식의 원본이 있는지 참고용으로 표시합니다. KIPRIS XML(한국 특허), HTML(웹문서), JSON(구조화 데이터), TXT/MD(일반 텍스트) 중에서 선택합니다. 이 선택은 화면의 파이프라인 설명에만 반영되며, 서버는 폴더 안의 모든 파일을 변환합니다.
파이프라인 실행
PT는 두 단계, SFT는 세 단계로 진행합니다. 각 단계는 개별 실행으로 따로 실행하거나 한 번에 실행할 수 있습니다.
- 압축 아카이브 자동 해제: 소스 폴더 안의
.zip·.tar.gz파일을 풀고 파일 목록을 확인합니다. - 문서 → Markdown 변환: 소스 폴더의 문서 파일(XML, HTML, JSON 등)을 Markdown으로 변환합니다. 변환된
.md파일은 소스 폴더에 생성됩니다. - Alpaca JSONL 생성 (SFT용): SFT를 선택한 경우에만 표시됩니다.
.md·.txt파일을 instruction/input/output 구조의 Alpaca JSONL로 변환합니다.
전체 파이프라인 일괄 실행에서 일괄 실행을 선택하면 모든 단계가 순서대로 실행됩니다. 완료되면 학습(Train) 탭에 연결을 선택해 데이터셋을 학습 탭으로 넘깁니다.