'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Recopilación e indexación
Compruebe si los documentos cargados están preparados para la búsqueda con IA. Los datos creados aquí se utilizan en RAG para recuperar documentos pertinentes que la IA consulta al elaborar la respuesta.
Antes de comenzar
- Permiso necesario: administrador de Workspace
- Debe haber un entorno de IA y un modelo de embeddings disponibles.
- Para la búsqueda vectorial, complete la conexión y el modelo en
Knowledge Storage.
Abrir Recopilación e indexación
- Acceda a la página de administración.
- Seleccione
Knowledge Services. - Seleccione
Ingestion & Indexing.
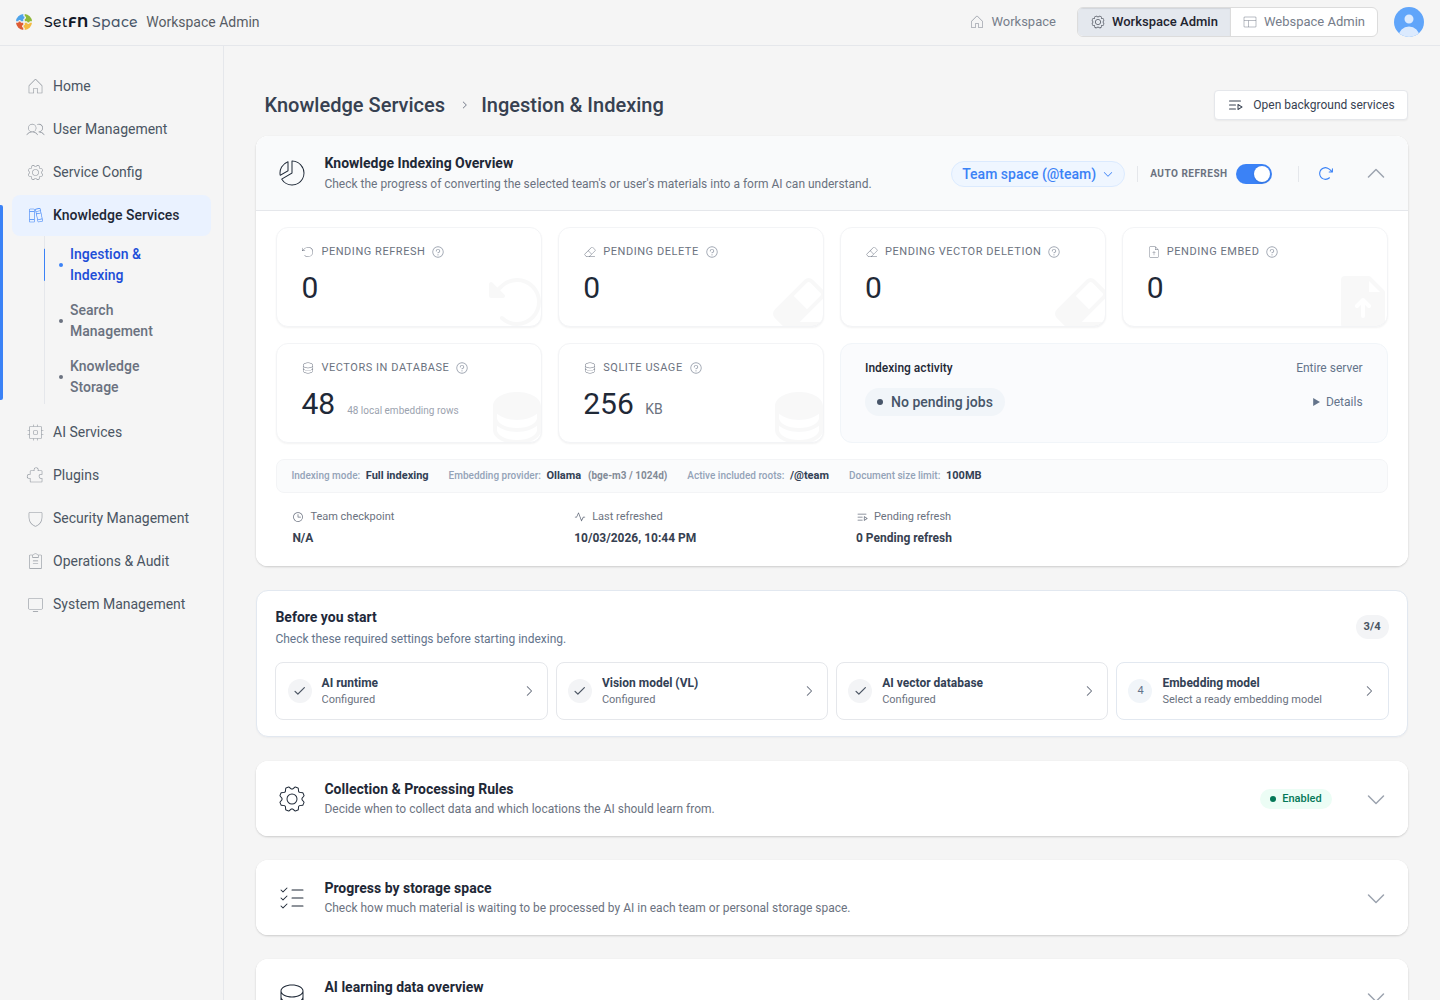
Resumen de indexación
| Campo | Descripción |
|---|---|
Pending refresh | Archivos nuevos o modificados pendientes de reflejarse en la búsqueda |
Pending delete | Datos de búsqueda de archivos eliminados pendientes de limpieza |
Pending vector deletion | Vectores antiguos pendientes de borrarse tras eliminar un archivo o cambiar el almacén |
Pending embed | Texto ya extraído que espera convertirse en datos de búsqueda |
Vectors in database | Vectores de este espacio en la DB elegida. local embedding rows muestra las filas por modelo de knowledge.db para la versión actual del documento y puede ser distinto. |
SQLite usage | Tamaño de la base de datos de registros; no incluye la base vectorial |
Indexing mode | Alcance de los archivos procesados |
Embedding provider | Modelo utilizado, por ejemplo Ollama bge-m3:latest / 1024d |
Active included roots | Rutas indexadas |
Team checkpoint | Última comprobación de carpetas de equipo |
Client checkpoint | Última comprobación de carpetas personales |
Last refreshed | Última actualización del estado |
Deje activado Auto refresh o seleccione Refresh para actualizar manualmente.
Mientras se consulta la base vectorial, o si falla, Vectors in database muestra -. Si el servidor devuelve temporalmente una instantánea anterior del mismo espacio, la pantalla conserva el valor más reciente y muestra una advertencia. Al cambiar entre Teamspace y Clientspace borra inmediatamente el valor anterior y muestra - hasta completar la consulta.
Comprobar la configuración antes de iniciar
| Configuración | Comprobación | Destino |
|---|---|---|
AI runtime | Seleccione Ollama, LM Studio u otro entorno y compruebe la conexión. | Configurar entornos de IA |
Vision model (VL) | Seleccione el modelo que leerá PDF e imágenes. | Prioridad de modelos de visión |
AI vector database | Elija Local (SQLite), Milvus, Qdrant u otra opción y configure la conexión. | Configurar la base vectorial |
Embedding model | Elija el modelo que convierte documentos en vectores, por ejemplo bge-m3. | Configurar el modelo |
Aquí solo se eligen los modelos. Descargue primero los modelos de visión y embeddings en Modelos de IA.
La tarjeta AI vector database comprueba también la conexión real. Muestra Connection error · check settings si no puede conectarse, Collection mismatch · review needed si las dimensiones o la distancia no coinciden y Collection not found · create it first si Milvus no tiene colección. Consulte el error al pasar el cursor; para Milvus, abra la configuración y siga Crear previamente una colección. En Qdrant, que la colección no exista aún es normal y se muestra Ready · collection is created on first indexing. Consulte Solución de problemas del almacén.
Reglas de recopilación y procesamiento
Determine cuándo se crean los datos y qué carpetas se incluyen.
Activar la indexación de conocimiento
Activa o desactiva toda la función.
Configurar el modo de indexación
| Campo | Descripción | Valor predeterminado |
|---|---|---|
Indexing mode | Alcance y método | Full indexing |
Wait time (minutes) | Tiempo desde que se detecta un cambio hasta que comienza | 20 |
Max concurrent workers | Cantidad máxima de trabajos a la vez | 1 |
Enable worker execution | Si se desactiva, detecta cambios pero no crea datos de búsqueda. | Enabled |
Auto pause on high load | Pausa cuando el servidor está ocupado y reanuda cuando se estabiliza. | Enabled |
Boost Mode | Empieza a indexar 5 segundos después de un cambio y adelanta los trabajos en cola. No acelera el procesamiento y se desactiva automáticamente cuando termina el trabajo pendiente. | Disabled |
Allowed time windows | Periodo de indexación; vacío significa en cualquier momento, por ejemplo 01:00-06:00. | No restriction |
Raíces incluidas
Introduzca las rutas que se indexarán. Si queda vacío, se incluyen todas.
/@team/docs
/@client/projects
Configurar el modelo de embeddings
| Proveedor | Descripción |
|---|---|
| Ollama | Modelo local de Ollama, por ejemplo bge-m3:latest |
| ONNX Local CPU | Modelo ONNX local ejecutado en la CPU |
| ONNX Local GPU | Modelo ONNX local con aceleración GPU |
| Remote API | Modelo utilizado mediante una API externa |
Un proveedor sin modelos instalados aparece como No models available.
| Campo | Descripción |
|---|---|
Vector dimensions | Tamaño de los datos de búsqueda, definido automáticamente según el modelo, por ejemplo 1024. |
PDF/Image extraction strategy | Método de extracción. VL first, OCR fallback significa utilizar primero visión y después reconocimiento de texto. |
Patrones incluidos de PDF e imágenes
*.pdf, *.png, image/**/*
Patrones excluidos de PDF e imágenes
Si queda vacío, se procesan todos los archivos incluidos.
thumbs.db, *.gif, cache/**
Progreso por espacio de almacenamiento
Consulte cuánto espera cada Teamspace o Clientspace para enviarse a la IA. Busque por espacio y usuario y ordene por actualizaciones pendientes.
| Campo | Descripción |
|---|---|
Space | Teamspace o Clientspace |
User | Usuario del Clientspace |
Pending refresh | Archivos nuevos o modificados pendientes |
Pending delete | Datos eliminados pendientes de limpieza |
Pending embed | Texto pendiente de convertirse en datos de búsqueda |
Embeddings | Total completado |
Estado de los datos para IA
Muestra cuántos datos de búsqueda se han creado por modelo; no entrena de nuevo el modelo con los documentos originales.
| Campo | Descripción |
|---|---|
Provider | Proveedor usado, por ejemplo ollama |
Model | Modelo utilizado, por ejemplo bge-m3:latest |
Count | Embeddings creados con el modelo |
Ordene por cantidad para comparar el volumen de datos de cada modelo.