'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Training
Sie führen das Fine-Tuning aus, indem Sie einen vorverarbeiteten Datensatz, ein Basismodell und eine Trainingsmethode (STAGE) angeben.
1. Trainingsdatensatz auswählen
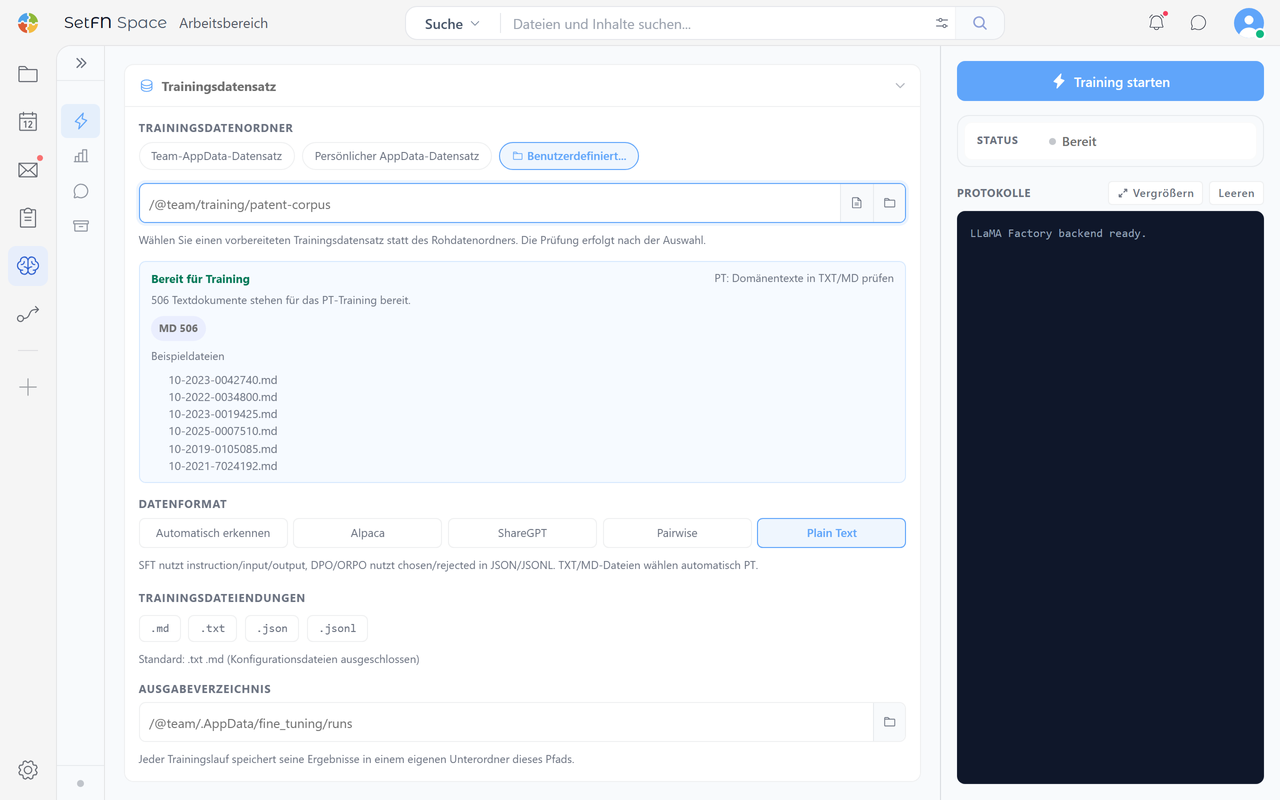
Wählen Sie nicht den ursprünglichen Quellordner, sondern einen Datensatzordner, der bereits für das Training aufbereitet ist. Wählen Sie zwischen Team-AppData-Trainingsset und Persönliches AppData-Trainingsset oder geben Sie unter Benutzerdefiniert... einen Pfad direkt ein. Sobald Sie einen Ordner auswählen, wird er darunter sofort geprüft und die Anzahl der trainierbaren Dateien angezeigt.
Datenformat
Wählen Sie zwischen automatischer Erkennung, Alpaca, ShareGPT, Pairwise und Plain Text.
- SFT verwendet JSON/JSONL auf Basis von instruction/input/output.
- DPO/ORPO verwendet JSON/JSONL auf Basis von chosen/rejected.
- .txt-/.md-Rohtext ist ausschließlich für Plain Text (PT-Pre-Training) vorgesehen; bei dieser Auswahl wechselt die Phase automatisch zu PT.
Dateiendungen für das Training und Ausgabeverzeichnis
Wählen Sie die Dateiendungen, die in das Training einfließen sollen (.md, .txt, .json, .jsonl), und geben Sie das Ausgabeverzeichnis an, in dem die Trainingsergebnisse gespeichert werden. Die Ergebnisse werden automatisch als Unterordner je Run-Nummer angelegt und getrennt gespeichert.
2. Modell auswählen
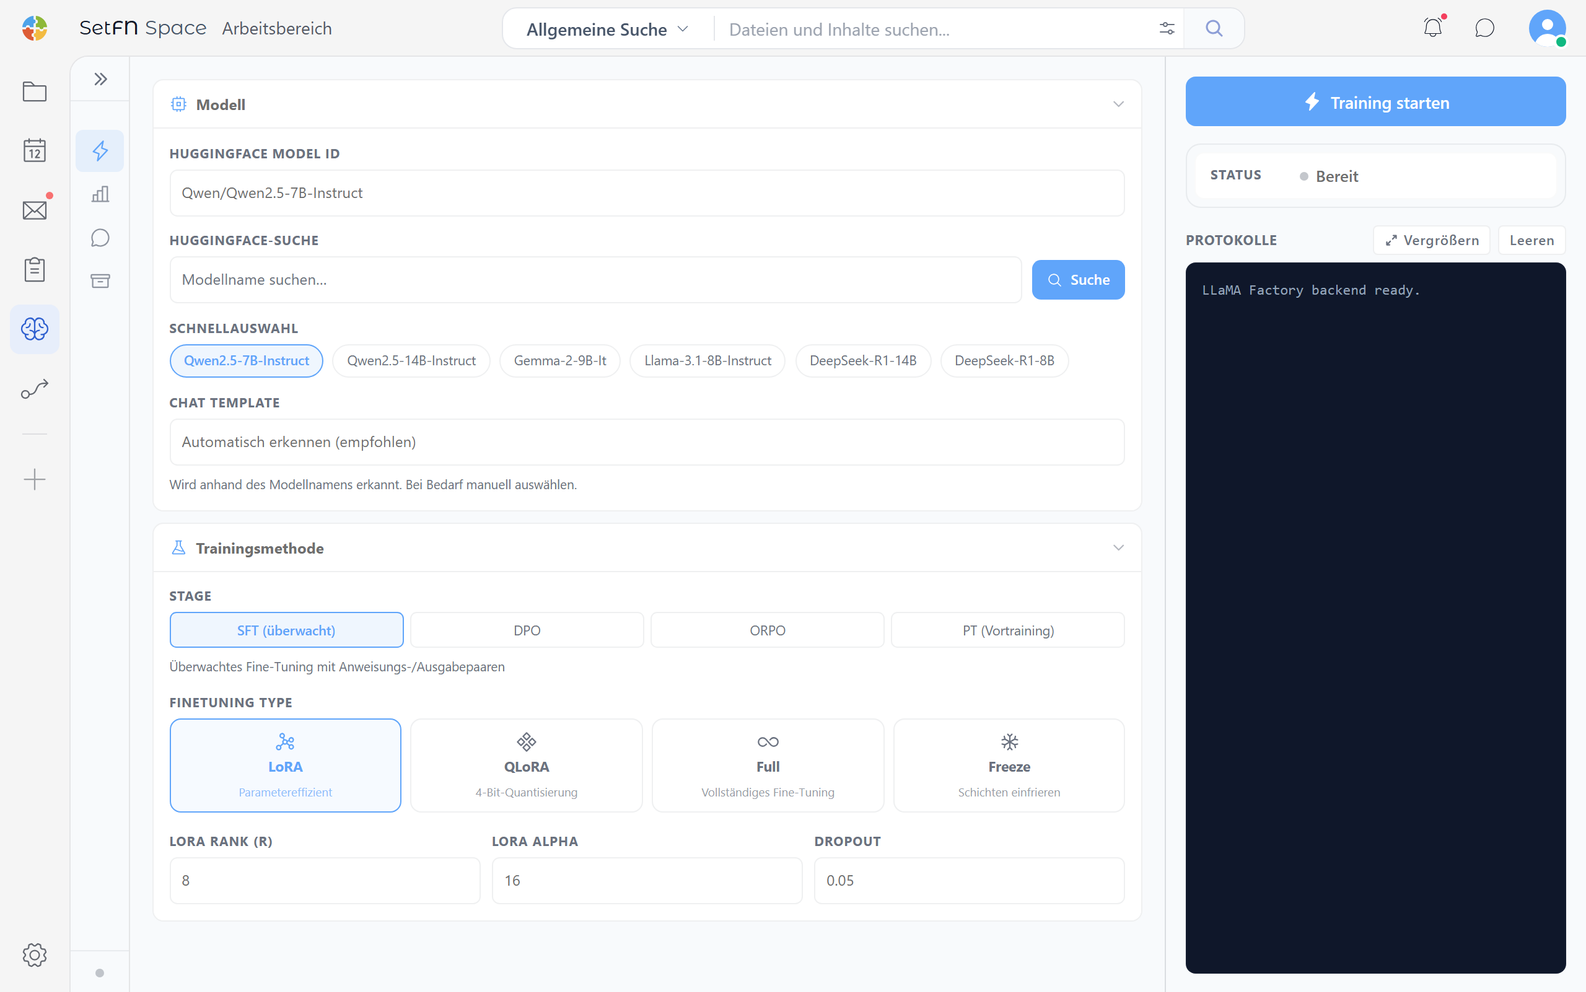
Geben Sie eine HUGGINGFACE MODEL ID direkt ein oder suchen Sie im Suchfeld nach einem Modell. Sie können auch schnell zwischen Qwen2.5-7B-Instruct, Qwen2.5-14B-Instruct, Gemma-2-9B-It, Llama-3.1-8B-Instruct, DeepSeek-R1-14B und DeepSeek-R1-8B wählen.
Für CHAT TEMPLATE wird standardmäßig die automatische Erkennung anhand des Modellnamens verwendet (empfohlen). Wählen Sie nur dann manuell, wenn sie nicht richtig funktioniert.
3. Trainingsmethode (STAGE) und Fine-Tuning-Verfahren auswählen
| STAGE | Beschreibung |
|---|---|
| SFT (überwachtes Lernen) | Bringt dem Modell mit instruction/input/output-Daten eine bestimmte Aufgabe bei |
| DPO | Trainiert Präferenzen mit chosen/rejected-Daten |
| ORPO | Ein präferenzbasiertes Alignment-Verfahren ähnlich wie DPO |
| PT (Pre-Training) | Continued Pre-Training. Trainiert Domänenwissen mit reinem Text |
Für FINETUNING TYPE wählen Sie zwischen LoRA, QLoRA (4-Bit-Quantisierung), Full (vollständiges Fine-Tuning) und Freeze (Einfrieren von Layern). Auch Hyperparameter wie LoRA RANK, LORA ALPHA und DROPOUT können Sie im Detail anpassen.
4. Training starten
Klicken Sie auf die Schaltfläche Training starten, um das Training zu beginnen. Im rechten Bereich sehen Sie Status, Modell, RUN ID, Pfad des Ergebnismodells und Fortschritt in Echtzeit, dazu wird das Protokoll ausgegeben. Um das Training zu beenden, klicken Sie auf die Schaltfläche Stoppen.
Hinweise
- Wenn Datenformat und Zielphase nicht zusammenpassen, startet das Training möglicherweise nicht.
- Während des Trainings können die Einstellungen desselben Runs nicht geändert werden.