'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Trainingsdaten vorverarbeiten
Rohdaten (XML, HTML, JSON, TXT) werden passend zum Trainingszweck (PT/SFT) umgewandelt und bereinigt und direkt mit dem Tab Training verbunden.
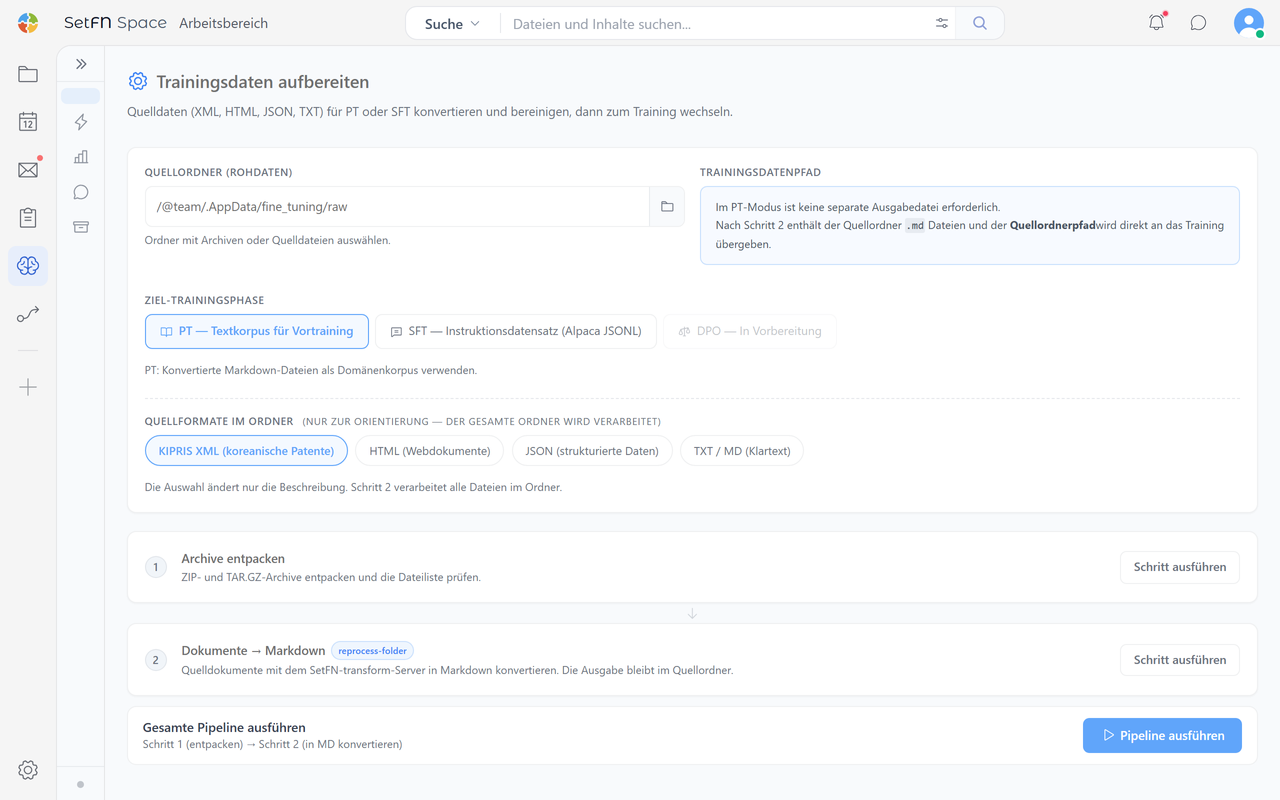
Quellordner angeben
Geben Sie den Pfad des Quellordners an, in dem Archivdateien (.zip/.tar.gz) oder Rohdateien (XML, HTML, JSON, TXT usw.) liegen. Der Standardpfad ist /@team/.AppData/fine_tuning/raw.
Ziel-Trainingsphase auswählen
Wählen Sie den Zweck der umzuwandelnden Daten.
| Phase | Beschreibung |
|---|---|
| PT — Rohtextkorpus für das Pre-Training | Verwendet alle umgewandelten MD-Dateien als Domänenkorpus für das Pre-Training |
| SFT — Instruktionsdatensatz (Alpaca JSONL) | Wandelt die Daten in einen Instruktionsdatensatz im Format instruction/input/output um |
| DPO | Wird noch nicht unterstützt |
Im PT-Modus ist keine separate Ausgabedatei nötig. Nach Abschluss der Umwandlung werden .md-Dateien im Quellordner erstellt, und der Pfad des Quellordners wird unverändert mit dem Tab Training verbunden.
Wenn Sie SFT wählen, wird Pfad der endgültigen Ausgabedatei (JSONL) angezeigt. Lassen Sie das Feld leer, wird die Datei als dataset.jsonl im Quellordner gespeichert.
Im Quellordner enthaltene Rohformate
Zur Orientierung wird angezeigt, welche Rohformate im Quellordner gemischt vorliegen. Sie können zwischen KIPRIS XML (koreanische Patente), HTML (Webdokumente), JSON (strukturierte Daten) und TXT/MD (einfacher Text) wählen; diese Auswahl wirkt sich nur auf die Pipeline-Beschreibung unten aus. Die eigentliche Verarbeitung auf dem Server wandelt alle Dateien im Ordner gesammelt um.
Pipeline ausführen
Für PT besteht die Pipeline aus zwei Schritten, für SFT aus drei. Sie können die Schritte einzeln oder zusammen in einem Durchgang ausführen.
- Archive automatisch entpacken: Entpackt die .zip-/.tar.gz-Dateien im Quellordner automatisch und zeigt die Dateiliste an.
- Dokument → Markdown umwandeln: Wandelt die Dokumentdateien (XML, HTML, JSON usw.) im Quellordner gesammelt in Markdown um. Die umgewandelten .md-Dateien werden im Quellordner erstellt.
- Alpaca-JSONL erstellen (für SFT): Wird nur angezeigt, wenn SFT gewählt ist. Wandelt .md-/.txt-Dateien in Alpaca-JSONL mit der Struktur instruction/input/output um.
Wählen Sie unter Gesamte Pipeline ausführen die Schaltfläche Gesammelt ausführen, werden alle Schritte nacheinander ausgeführt. Wählen Sie anschließend Mit Tab Training verbinden, um den Datensatz an den Tab Training zu übergeben.