'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Preprocesar datos de entrenamiento
Convierta y limpie datos (XML, HTML, JSON, TXT) según el objetivo (PT/SFT) y conéctelos directamente con la pestaña Training.
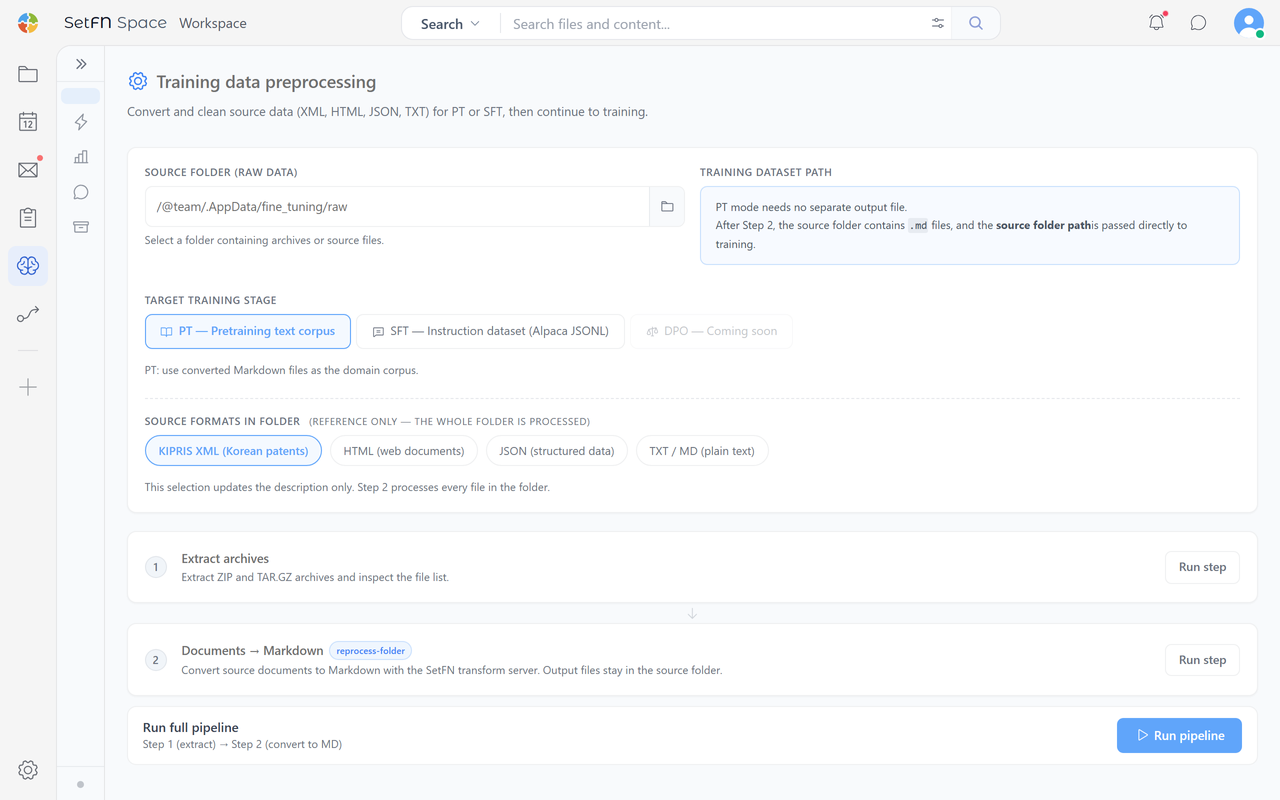
Indicar la carpeta de origen
Indique la ruta que contiene archivos comprimidos (.zip/.tar.gz) o datos sin procesar (XML, HTML, JSON, TXT, etc.). La ruta predeterminada es /@team/.AppData/fine_tuning/raw.
Elegir la etapa de entrenamiento
| Etapa | Descripción |
|---|---|
| PT — Pre-training raw corpus | Usa todos los archivos MD convertidos como corpus de dominio para preentrenamiento |
| SFT — Instruction dataset (Alpaca JSONL) | Convierte los datos al formato instruction/input/output |
| DPO | Todavía no es compatible |
En PT no hace falta un archivo de salida separado. Tras la conversión, se crean archivos .md en la carpeta de origen y su ruta se conecta directamente con Training.
Si selecciona SFT, aparece Final output file path (JSONL). Si lo deja vacío, el archivo se guarda como dataset.jsonl en la carpeta de origen.
Formatos de datos de origen
Esta sección indica los formatos mezclados en la carpeta. Puede elegir KIPRIS XML (patentes coreanas), HTML, JSON y TXT/MD; esta selección solo cambia la descripción del pipeline. El servidor convierte por lotes todos los archivos de la carpeta.
Ejecutar el pipeline
En PT hay dos etapas y en SFT, tres. Pueden ejecutarse por separado o juntas.
- Extracción automática: descomprime .zip/.tar.gz y enumera los archivos.
- Conversión de documentos → Markdown: convierte por lotes XML, HTML, JSON y otros documentos. Los
.mdse crean en la carpeta de origen. - Generación de Alpaca JSONL (para SFT): solo aparece si selecciona SFT. Convierte los archivos .md/.txt a Alpaca JSONL con la estructura instruction/input/output.
En Run Full Pipeline in Batch, seleccione Run in Batch para ejecutar todas las etapas en orden. Al terminar, seleccione Connect to Training Tab para pasar el conjunto de datos a Training.