'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Probar el chat
Cargue o conecte un modelo entrenado y compruebe el resultado conversando con él.
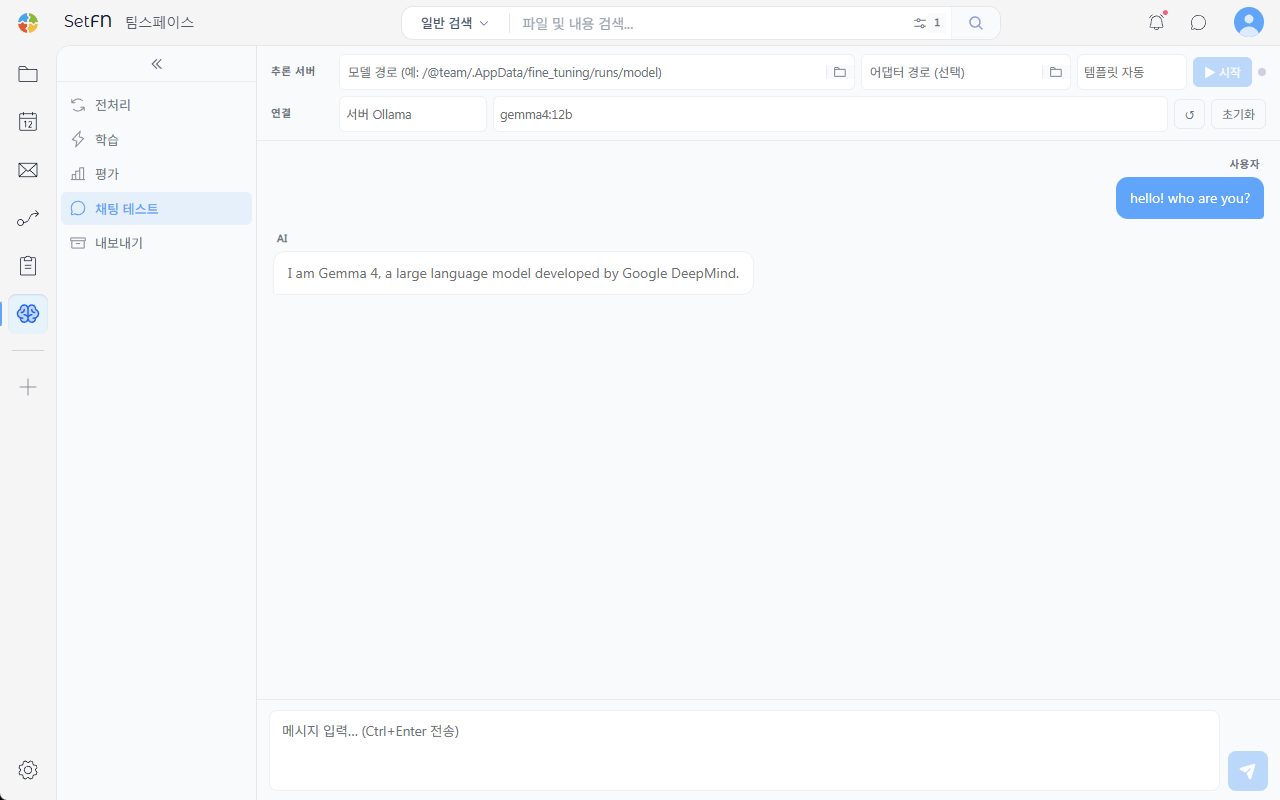
Cargar un modelo en el servidor de inferencia
- Model path: ruta del modelo, por ejemplo
/@team/.AppData/fine_tuning/runs/model. - Adapter path (opcional): ruta de pesos de adaptador entrenados por separado, como LoRA.
- Template: se detecta automáticamente de forma predeterminada.
Introduzca la ruta y seleccione Start para iniciar el servidor. Connect cambia entonces a Inference server.
Conectar un servidor Ollama
- En
Connect, seleccioneServer OllamaoLocal Ollama (my PC). - Cargue la lista de modelos con el botón de actualización (
↺). - Seleccione el modelo que quiere probar, por ejemplo
gemma4:12b.
Si selecciona Custom API, introduzca usted mismo la dirección de la API y el nombre del modelo. Seleccione Reset para borrar la conversación.
Comprobar el resultado mediante conversación
Escriba un mensaje y envíelo con Ctrl+Enter o con el botón de envío. Haga preguntas relacionadas con el objetivo del entrenamiento para comprobar la calidad y el formato.
Información útil
- Un modelo que solo haya completado PT puede continuar texto en vez de seguir instrucciones. Para comprobar instrucciones, use uno que también haya completado SFT.
- Si Model path está vacío, no puede seleccionar
Start. Indique Model path también cuando use un adaptador.