'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Introducción a Fine-tuning
Fine-tuning, basado en LLaMA Factory, entrena un LLM local —incluidos modelos pequeños como sLLM— para el dominio que necesite. Desde una sola pantalla puede preprocesar los datos, entrenar, evaluar, probar el chat y exportar el modelo resultante. La pantalla se muestra actualmente en coreano; las etiquetas de este documento son traducciones.
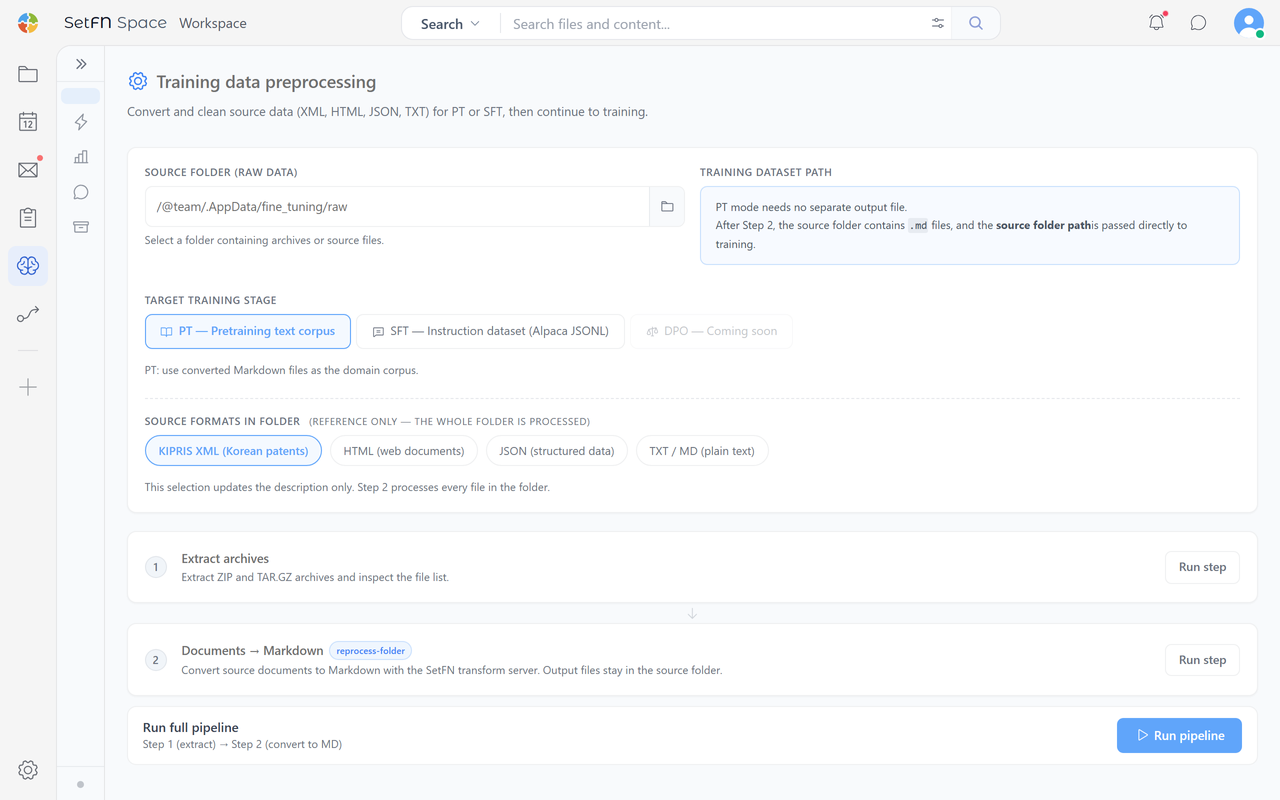
Flujo de trabajo
Fine-tuning consta de cinco etapas.
| Etapa | Descripción |
|---|---|
| Preprocessing | Convierte y limpia datos (XML, MD, HTML, JSON, TXT) según el objetivo (PT/SFT) |
| Training | Ejecuta el entrenamiento indicando el conjunto de datos, el modelo y el método (STAGE) |
| Evaluation | Revisa una ejecución terminada y vuelve a validar el conjunto de datos |
| Chat Test | Permite conversar con el modelo entrenado para comprobarlo |
| Export | Gestiona ejecuciones y conecta pesos correctos como Base Model de la siguiente ronda |
Información útil
- El entrenamiento necesita recursos de GPU. Compruebe antes las especificaciones del servidor.
- Una vez iniciado, continúa en segundo plano hasta que lo detenga.