'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
수집·인덱싱
수집·인덱싱에서는 문서를 AI 검색 데이터로 만드는 범위와 규칙을 정하고 처리 상태를 확인합니다. 이 데이터는 AI가 관련 문서를 찾아 답변하는 RAG에 사용됩니다.
시작하기 전에
- 필요 권한: 관리자
- 임베딩을 실행할 AI 런타임과 모델이 준비되어 있어야 합니다.
- 벡터 검색을 사용하려면
지식 저장소의 연결과 임베딩 모델 설정을 완료해야 합니다.
수집·인덱싱 열기
- 관리자 페이지에 접속합니다.
- 왼쪽 메뉴에서
지식 서비스를 선택합니다. 수집·인덱싱을 선택합니다.
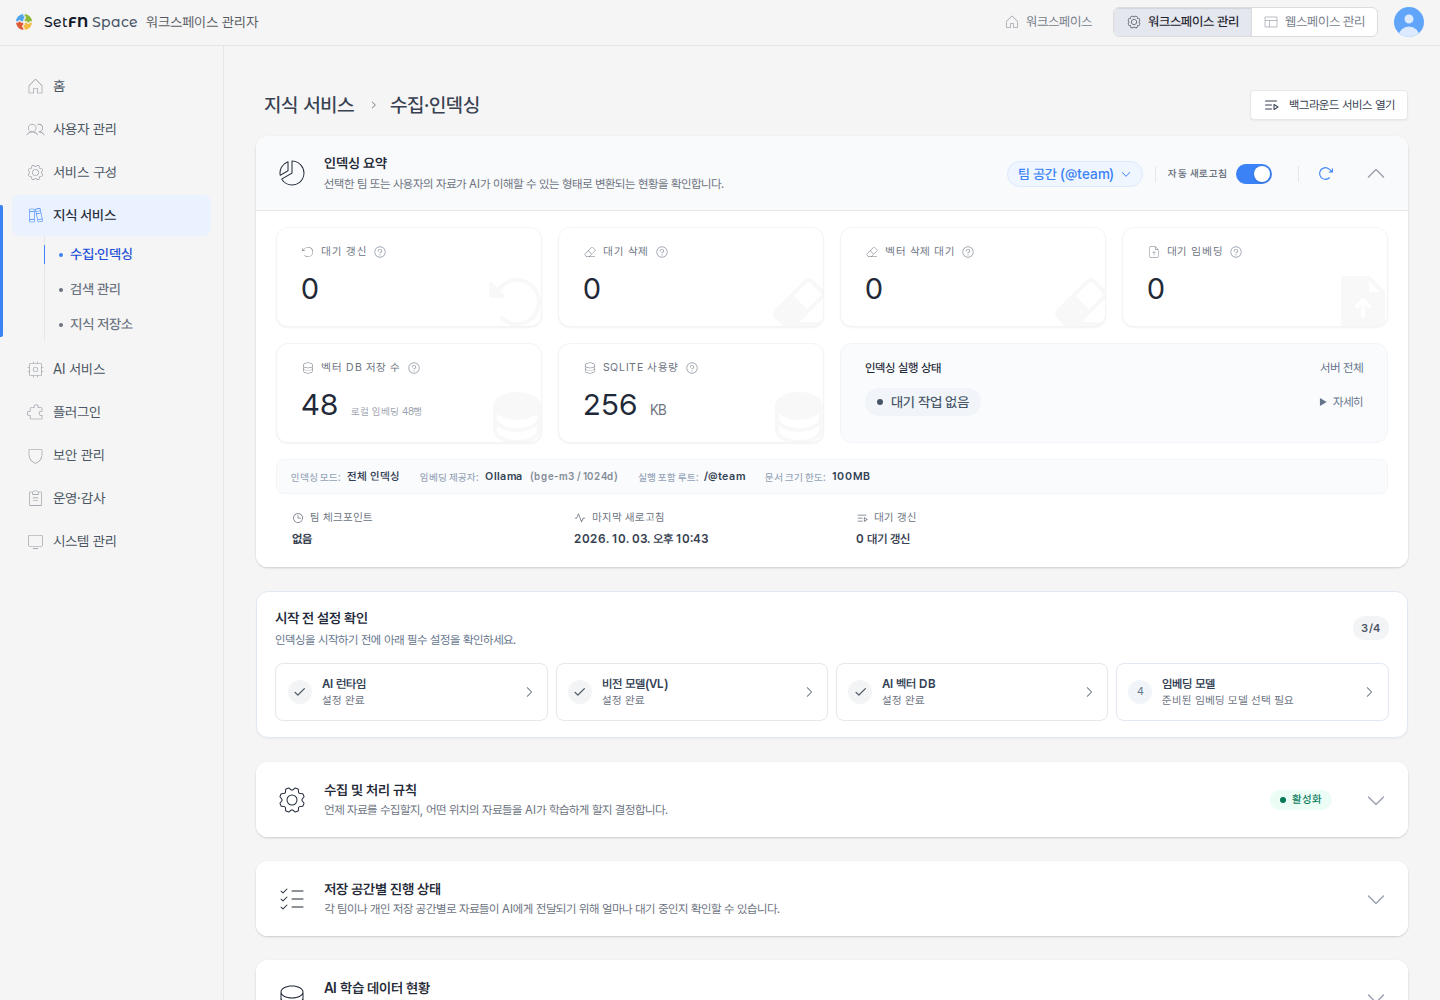
인덱싱 요약
현재 인덱싱 상태를 확인합니다.
| 항목 | 설명 |
|---|---|
| 대기 갱신 | 새로 만들거나 수정해 AI 검색 반영을 기다리는 파일 수 |
| 대기 삭제 | 삭제한 파일 중 검색 데이터 정리를 기다리는 수 |
| 벡터 삭제 대기 | 파일 삭제나 저장소 전환 뒤 원래 저장 위치에서 삭제를 기다리는 이전 벡터 수 |
| 대기 임베딩 | 글자 추출을 마치고 AI 검색 데이터로 변환을 기다리는 수 |
| 벡터 DB 저장 수 | 선택한 벡터 DB에 현재 공간의 벡터가 실제로 저장된 수. 카드 아래의 로컬 임베딩은 로컬 knowledge.db에 보관된 현재 문서 버전의 모델별 임베딩 행 수이므로 두 값은 다를 수 있습니다. |
| SQLite 사용량 | 지식 인덱싱 기록 DB의 용량. 벡터 DB 용량은 포함하지 않습니다. |
| 인덱싱 모드 | AI 검색 데이터를 만들 파일의 범위 (예: 전체 인덱싱) |
| 임베딩 제공자 | 사용 중인 AI 임베딩 모델 (예: Ollama bge-m3:latest / 1024d) |
| 실행 포함 루트 | 인덱싱 대상 경로 |
| 팀 체크포인트 | 팀 폴더를 마지막으로 확인한 시각 |
| 클라이언트 체크포인트 | 개인 폴더를 마지막으로 확인한 시각 |
| 마지막 새로고침 | 상태 마지막 갱신 시각 |
자동 새로고침을 켜거나 새로고침을 선택해 현황을 갱신합니다.
벡터 DB 상태를 확인 중이거나 확인하지 못하면 벡터 DB 저장 수가 -로 표시됩니다. 서버 집계가 늦어지면 마지막으로 확인한 값을 유지하고 현황이 오래되었다는 경고를 표시합니다. 팀 공간과 개인 공간을 바꾸면 새 공간의 조회가 끝날 때까지 값이 -로 표시됩니다.
시작 전 설정 확인
인덱싱을 시작하기 전에 아래 필수 설정을 확인합니다. 카드를 선택하면 해당 설정으로 이동합니다.
| 필수 설정 | 확인할 내용 | 이동 |
|---|---|---|
| AI 런타임 | Ollama, LM Studio 등 인덱싱에 사용할 AI 런타임을 선택하고 연결 상태를 확인합니다. | AI 런타임 설정하기 |
| 비전 모델(VL) | PDF와 이미지의 내용을 읽을 비전 모델을 AI 모델 중에서 선택합니다. | 비전 모델 설정하기 |
| AI 벡터 DB | 벡터 DB 드라이버(Automatic, Local, Qdrant, Milvus)를 선택하고 연결 정보를 설정합니다. | AI 벡터 DB 설정하기 |
| 임베딩 모델 | 문서를 검색용 벡터로 변환할 모델(예: bge-m3)을 선택합니다. | 임베딩 모델 설정하기 |
여기서는 사용할 모델을 고르기만 합니다. 비전 모델과 임베딩 모델은 모델·런타임에서 먼저 설치해야 인덱싱에 쓸 수 있습니다.
AI 벡터 DB 카드는 설정 여부와 함께 실제 연결 상태도 확인합니다. 문제가 있으면 다음 표시가 경고 색으로 나타납니다.
| 표시 | 원인과 조치 |
|---|---|
DB 연결 오류 · 설정 확인 필요 | 벡터 DB에 접속할 수 없습니다. 카드에 마우스를 올리면 자세한 오류가 표시됩니다. |
컬렉션 설정 불일치 · 확인 필요 | 컬렉션의 차원이나 거리 계산 방식이 설정과 다릅니다. 카드에 마우스를 올리면 자세한 오류가 표시됩니다. |
컬렉션 없음 · 먼저 만들어야 합니다 | Milvus 컬렉션을 아직 만들지 않았습니다. Milvus 연결을 참고해 컬렉션을 만듭니다. |
Qdrant 컬렉션이 아직 없으면 오류가 아니므로 설정 완료 · 컬렉션은 첫 인덱싱 때 생성으로 표시됩니다. 자세한 조치는 지식 저장소 운영하기를 참고합니다.
수집 및 처리 규칙
언제 검색 데이터를 만들지, 어느 폴더의 문서를 AI 검색에 사용할지 정합니다.
지식 인덱싱 활성화
전체 지식 인덱싱 기능을 켜거나 끕니다.
인덱싱 모드 설정
| 항목 | 설명 | 기본값 |
|---|---|---|
| 인덱싱 모드 | 인덱싱 범위 및 방식 선택 | 전체 인덱싱 |
| 대기 시간(분) | 파일 변경 감지 후 인덱싱 시작까지 대기하는 시간 | 20 |
| 최대 동시 작업 수 | 동시에 처리할 수 있는 인덱싱 작업 수 | 1 |
| 워커 실행 허용 | 끄면 변경된 파일은 계속 찾지만 AI 검색 데이터는 만들지 않습니다. | 활성 |
| 고부하 시 자동 일시정지 | 서버 사용량이 높으면 인덱싱을 잠시 멈추고, 서버가 안정되면 다시 시작합니다. | 활성 |
| 부스트 모드 | 파일 변경 5초 뒤 인덱싱을 시작하고 밀린 작업을 바로 처리 대상으로 당깁니다. 처리 속도는 빨라지지 않으며, 밀린 작업이 끝나면 자동으로 꺼집니다. | 비활성 |
| 허용 시간대 | 인덱싱을 허용할 시간대를 지정합니다. 비워두면 언제든 인덱싱합니다. (예: 01:00-06:00) | 제한 없음 |
포함 루트
인덱싱할 폴더 경로를 지정합니다. 비워 두면 전체 경로가 대상입니다.
예시:
/@team/docs
/@client/projects
AI 임베딩 모델 설정
문서를 검색 데이터로 바꾸는 AI 모델을 선택합니다.
| 제공자 | 설명 |
|---|---|
| Ollama | 로컬에 설치된 Ollama 모델을 사용합니다. (예: bge-m3:latest) |
| ONNX Local CPU | CPU 기반으로 로컬에서 실행되는 ONNX 모델을 사용합니다. |
| ONNX Local GPU | GPU 가속을 사용하는 로컬 ONNX 모델을 사용합니다. |
| Remote API | 외부 API를 통해 임베딩 모델을 사용합니다. |
모델이 설치되어 있지 않은 제공자는 사용 가능한 모델 없음으로 표시됩니다.
| 항목 | 설명 |
|---|---|
| 벡터 차원 | AI 모델이 사용하는 검색 데이터의 크기입니다. 선택한 모델에 맞춰 자동으로 설정됩니다. (예: 1024) |
| PDF/이미지 추출 전략 | PDF와 이미지에서 글자를 읽는 방법을 선택합니다. VL 우선, 실패 시 OCR은 비전 모델로 먼저 읽고, 실패하면 OCR을 사용합니다. |
PDF/이미지 포함 패턴
글자를 읽을 PDF와 이미지 파일의 확장자 또는 경로 규칙을 입력합니다.
예시:
*.pdf, *.png, image/**/*
PDF/이미지 제외 패턴
처리하지 않을 PDF와 이미지 파일의 확장자 또는 경로 규칙을 입력합니다. 비워 두면 위에서 포함한 파일을 모두 처리합니다.
예시:
thumbs.db, *.gif, cache/**
저장 공간별 진행 상태
팀 공간과 개인 공간별로 인덱싱을 기다리는 작업 수를 확인합니다.
스페이스(team/client)나 사용자로 검색하고, 대기 갱신 수로 정렬할 수 있습니다.
| 항목 | 설명 |
|---|---|
| 스페이스 | 팀 공간(team) 또는 개인 공간(client) 구분 |
| 사용자 | 개인 공간의 경우 해당 사용자 |
| 대기 갱신 | 새로 만들거나 수정해 AI 검색 반영을 기다리는 파일 수 |
| 대기 삭제 | 삭제한 파일 중 검색 데이터 정리를 기다리는 수 |
| 대기 임베딩 | 글자 추출을 마치고 AI 검색 데이터로 변환을 기다리는 수 |
| 임베딩 수 | 완료된 임베딩 수 |
AI 학습 데이터 현황
AI 검색 데이터가 모델별로 얼마나 만들어졌는지 확인합니다. 원본 문서로 AI 모델을 새로 학습시키는 기능은 아닙니다.
| 항목 | 설명 |
|---|---|
| 제공자 | 임베딩에 사용된 모델 제공자 (예: ollama) |
| 모델 | 사용된 임베딩 모델명 (예: bge-m3:latest) |
| 개수 | 해당 모델로 만든 임베딩 수 |
개수 기준으로 정렬해 모델별 검색 데이터 규모를 비교할 수 있습니다.