'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
Búsqueda contextual (búsqueda con AI)
Encuentre archivos relacionados por su significado aunque no coincidan exactamente con las palabras clave.
Antes de utilizarla
Knowledge Indexing debe estar activado en la configuración del administrador. Solo pueden buscarse mediante la búsqueda contextual los archivos cuya indexación haya finalizado.
La búsqueda contextual convierte el significado de los archivos en vectores y los almacena. Por tanto, debe haber un modelo de embedding disponible localmente para realizar la conversión.
Tanto la indexación como la búsqueda se procesan dentro del espacio de trabajo, por lo que los archivos no se envían fuera de él.
- Modelo de embedding: modelo que convierte texto en vectores. Si hay muchos documentos en varios idiomas, se recomienda un modelo con buena compatibilidad multilingüe, como
bge-m3. - Para ver también los documentos de origen, la indexación debe haberse completado con este modelo de embedding.
→ Preparar un modelo de embedding e indexar documentos: Configuración de la indexación de conocimiento
Cómo buscar
- Seleccione
Context Searchen el menú situado a la izquierda del campo de búsqueda. - Seleccione el botón
🪄situado a la derecha del campo para activar la ayuda de búsqueda con AI.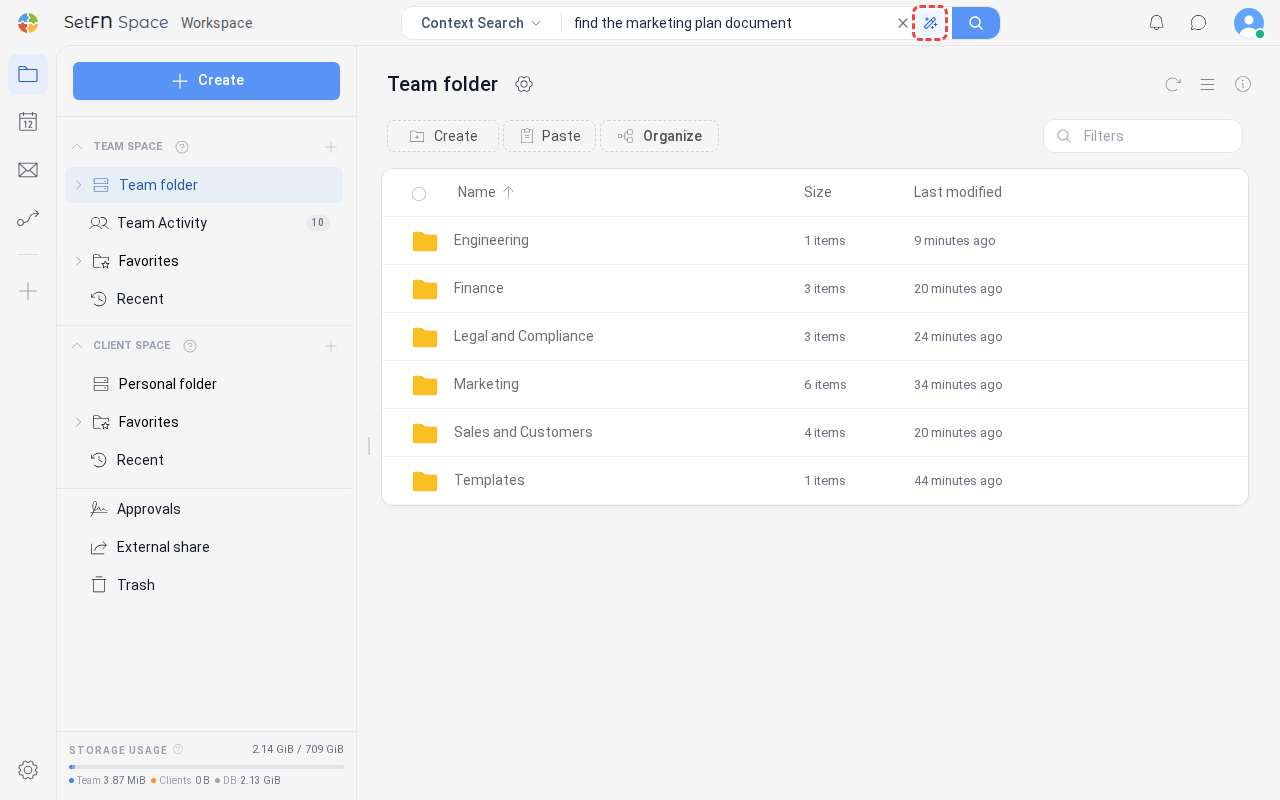
Resultados de búsqueda con AI
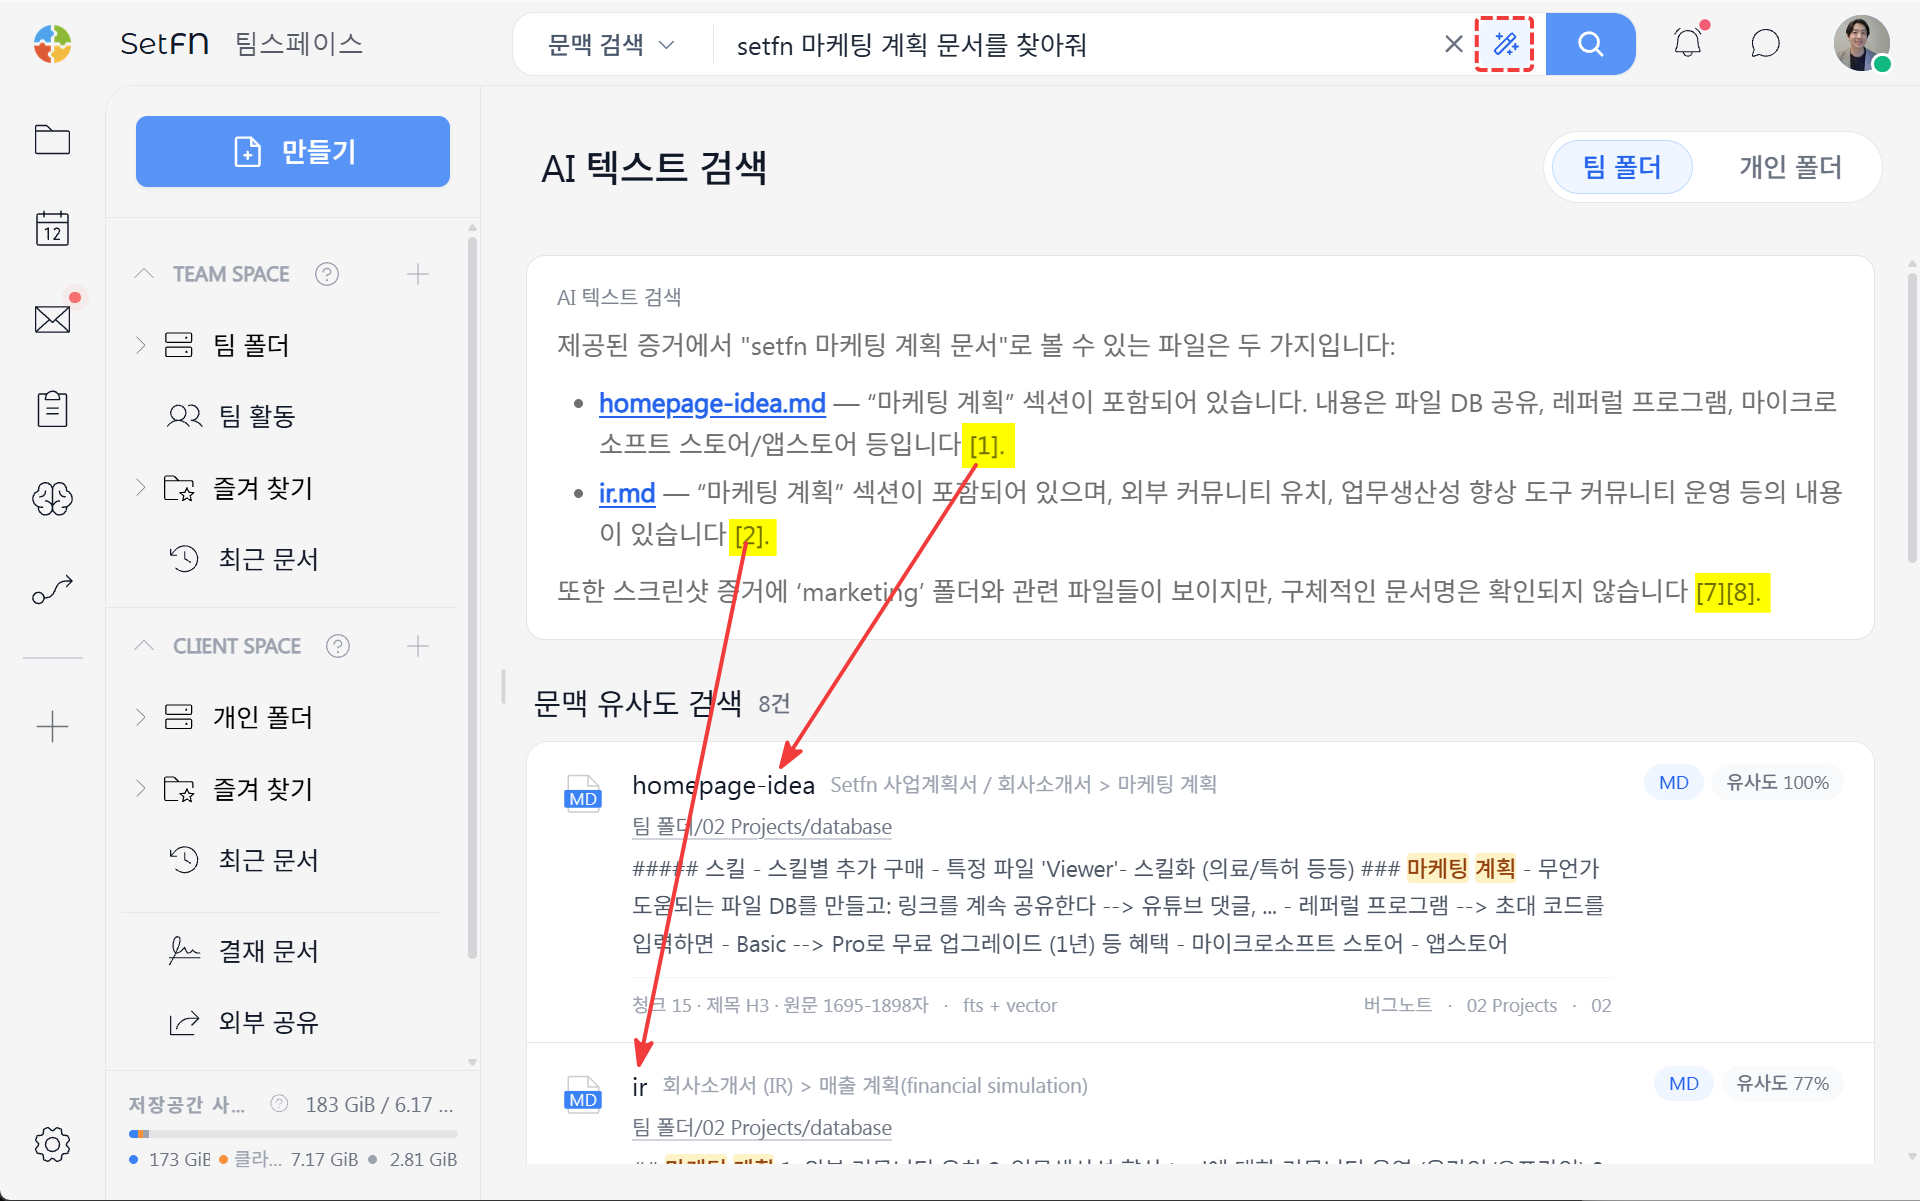
La AI resume los resultados y muestra los documentos internos utilizados como fuentes.
Los números de las fuentes corresponden al orden de la lista de resultados por similitud contextual. Los documentos mostrados como fuentes son los materiales en los que la AI ha basado su respuesta.
Respuestas basadas en sus documentos reales (RAG)
La búsqueda contextual no depende únicamente del conocimiento general de la AI. Primero encuentra documentos del espacio de trabajo relacionados con la pregunta y proporciona su contenido como material de referencia para mostrar una respuesta con sus fuentes. Este enfoque se denomina generación aumentada por recuperación (RAG, Retrieval-Augmented Generation).
El uso de documentos reales en una respuesta consta de dos etapas: indexación y búsqueda.
Indexación (preparación)
- Cada archivo se divide en unidades con significado llamadas fragmentos.
- Un modelo de embedding, como
bge-m3, convierte cada fragmento en un vector. - Los vectores generados se guardan en el almacén vectorial del espacio de trabajo.
Búsqueda (al formular una pregunta)
- La pregunta se convierte en un vector mediante el mismo modelo de embedding.
- El sistema encuentra los fragmentos más cercanos por orden de similitud.
- Los fragmentos encontrados se proporcionan a la AI como material de referencia.
- La AI resume una respuesta a partir de ese material y muestra los documentos que contienen los fragmentos citados.
Esta estructura permite encontrar documentos internos de significado similar aunque no contengan exactamente la palabra clave. La respuesta incluye los documentos consultados, de modo que puede abrirlos y comprobar directamente las fuentes.
Las preguntas y los documentos deben convertirse en vectores con el mismo modelo para poder compararlos. Si cambia el modelo utilizado en la indexación, deberá volver a indexar todos los archivos.
Diferencias respecto a la búsqueda general
| Búsqueda general | Búsqueda contextual | |
|---|---|---|
| Método | Coincidencia de texto por palabras clave | Búsqueda semántica mediante embeddings de AI |
| Términos de búsqueda | Requiere palabras exactas | Admite lenguaje natural y expresiones similares |
| Objetivo | Nombres y contenido de archivos | Archivos con indexación de conocimiento |
| Requisitos | Ninguno | Modelo de embedding local e indexación de conocimiento |
Información útil
- Inmediatamente después de indexar, los resultados pueden estar incompletos. Espere a que termine la indexación.
- Los resultados pueden variar según cómo formule la pregunta. Pruebe distintas expresiones.
- La calidad depende del rendimiento y de los idiomas compatibles con el modelo de embedding.
- Si cambia el modelo, el índice existente dejará de ser compatible y tendrá que volver a indexar todos los documentos.