'/%3e%3cpath%20id='cross_2'%20data-name='cross%202'%20class='cls-2'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.193%200.007)%20rotate(90)'/%3e%3cpath%20id='cross_3'%20data-name='cross%203'%20class='cls-3'%20d='M20.612,30.43h0a5.361,5.361,0,1,0-10.723,0H0A33.709,33.709,0,0,1,30.569,0V9.75a5.361,5.361,0,1,1,0,10.723V30.43Z'%20transform='translate(67.186%2067.041)%20rotate(180)'/%3e%3cpath%20id='cross_4'%20data-name='cross%204'%20class='cls-4'%20d='M20.6,30.5h0a5.361,5.361,0,1,0-10.723,0H0A33.71,33.71,0,0,1,30.56,0V9.818a5.361,5.361,0,1,1,0,10.723V30.5Z'%20transform='translate(0%2067.041)%20rotate(-90)'/%3e%3c/svg%3e)
文脈検索(AI検索)
キーワードが正確に一致しなくても、意味を理解して関連ファイルを検索できます。
使用する前に
管理者設定でナレッジインデックスが有効になっている必要があります。インデックス作成が完了したファイルだけが、文脈検索の対象になります。
文脈検索は、ファイルの意味をベクトルに変換して保存する方式のため、この変換を担う埋め込みモデルがローカルに用意されている必要があります。
インデックス作成と検索の両方をワークスペースの内部で処理するため、ファイルが外部に出ることはありません。
- 埋め込みモデル:テキストをベクトルに変換するモデルです。韓国語の文書が多い場合は、多言語をうまく扱えるモデルを推奨します(例:bge-m3)。
- 文書の出典まで併せて確認するには、この埋め込みモデルでインデックス作成が完了している必要があります。
→ 埋め込みモデルの準備とインデックス作成の方法:ナレッジインデックス設定
検索方法
- 上部の検索ボックスの左側にあるメニューで「文脈検索」を選択します。
- AI検索アシスト
検索ボックスの右側にある
🪄ボタンを押して、AI検索アシスト機能を有効にできます。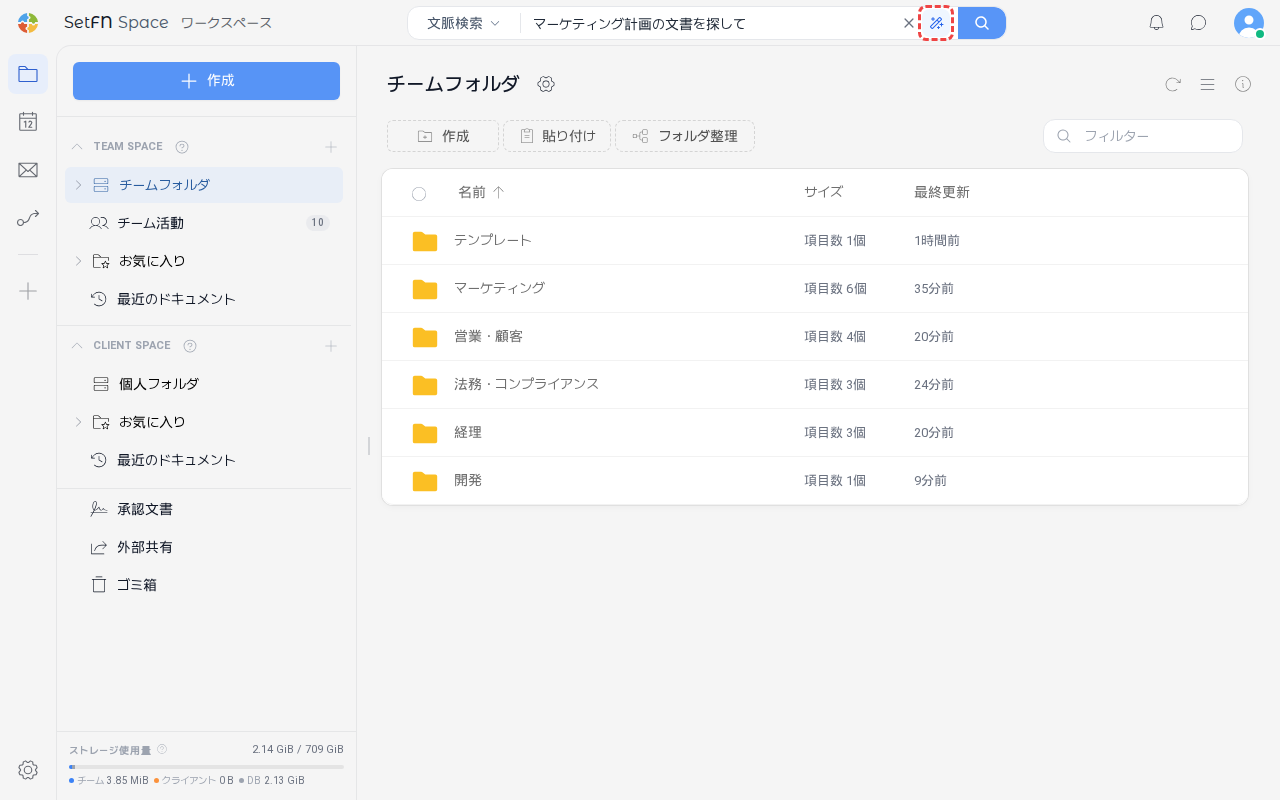
AI検索の結果
AIが検索結果を要約し、社内文書の出典とともに知らせます。
文書の出典の番号は、文脈類似度検索で表示された一覧の順番に対応しています。出典として表示された文書が、AIが回答を作成するときに根拠とした資料です。
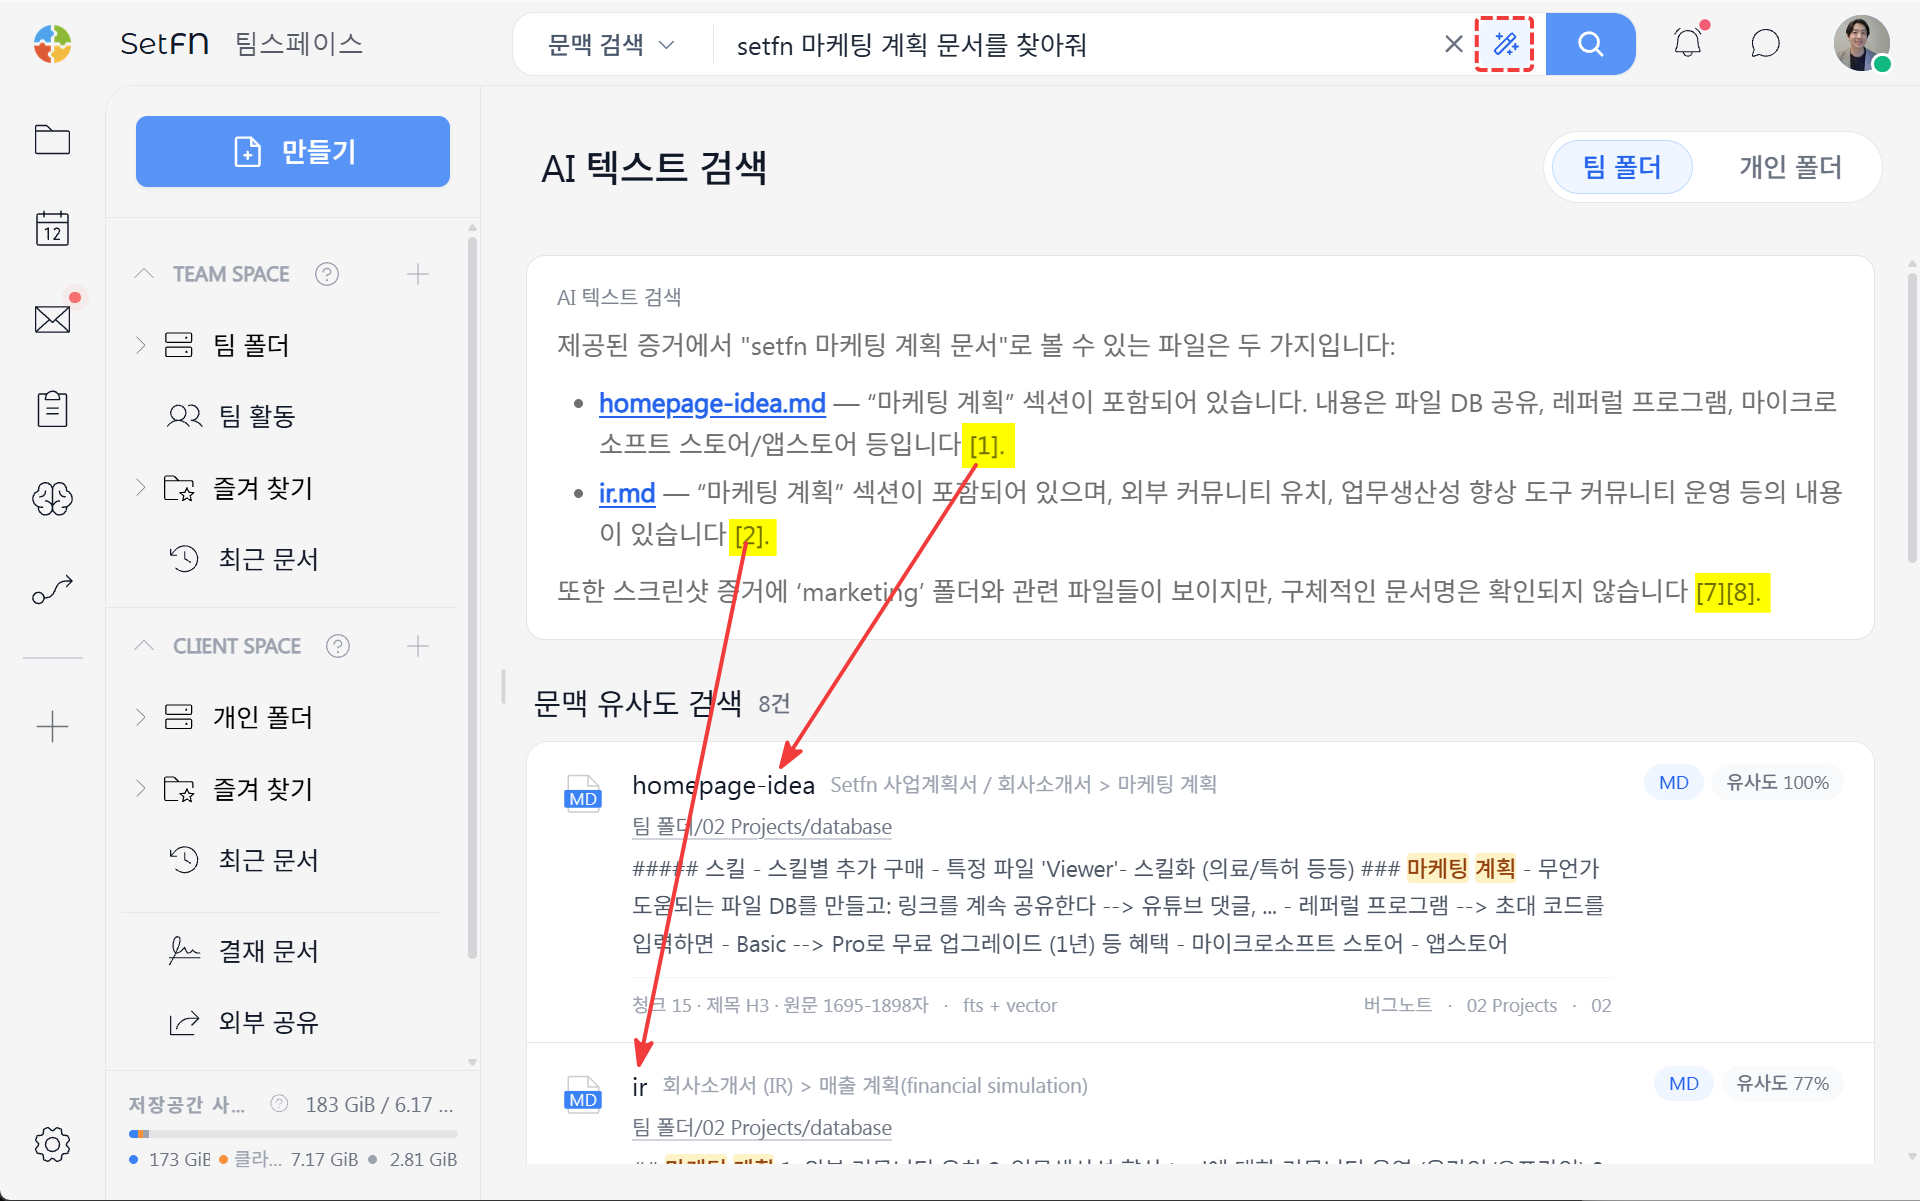
実際の文書を根拠に回答します(RAG)
文脈検索は、AIの一般的な知識だけには頼りません。ワークスペースから質問に関連する実際の文書を先に探し、その内容を根拠資料として渡して、回答と出典を併せて表示します。これを検索拡張生成(RAG、Retrieval-Augmented Generation)といいます。
実際の文書を探して回答に活用する過程は、インデックス作成と検索の2段階で構成されます。
インデックス作成(事前準備)
- ファイルを意味の単位(チャンク)に分割します。
- 埋め込みモデル(例:bge-m3)が各チャンクをベクトルに変換します。
- 変換されたベクトルを、ワークスペースのベクトルストレージに保管します。
検索(質問するとき)
- 入力した質問も、同じ埋め込みモデルでベクトルに変換します。
- 質問のベクトルに最も近いチャンクを、類似度の高い順に探します。
- 見つかったチャンクを、根拠資料としてAIに渡します。
- AIがその資料をもとに回答を要約し、使用したチャンクを文書の出典として表示します。
この仕組みにより、正確なキーワードを入力しなくても、意味の近い社内文書を探せます。AIの回答には実際に参照した文書の出典が併せて表示されるため、回答の根拠を直接開いて確認できます。
質問と文書は、同じ埋め込みモデルでベクトル化されていなければ互いに比較できません。そのため、インデックス作成に使用した埋め込みモデルを変更した場合は、すべてのファイルを再インデックスする必要があります。
一般検索との違い
| 一般検索 | 文脈検索 | |
|---|---|---|
| 方式 | キーワードのテキストマッチング | AI埋め込みベースの意味検索 |
| 検索語 | 正確な単語が必要 | 自然言語、類似した表現が可能 |
| 対象 | ファイル名・ファイル内容 | ナレッジインデックスが作成されたファイル |
| 必要条件 | なし | ローカル埋め込みモデル、ナレッジインデックス |
注意事項
- インデックス作成の直後は、検索結果に漏れが生じることがあります。インデックス作成が完了してから検索してください。
- 質問の仕方によって、AIの検索結果に違いが出ます。さまざまな方法で質問してみてください。
- 埋め込みモデルの性能と対応言語の範囲が、検索の品質を左右します。
- 埋め込みモデルを入れ替えると、既存のインデックスと互換性がなくなるため、全体の再インデックスが必要です。